Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dati senior
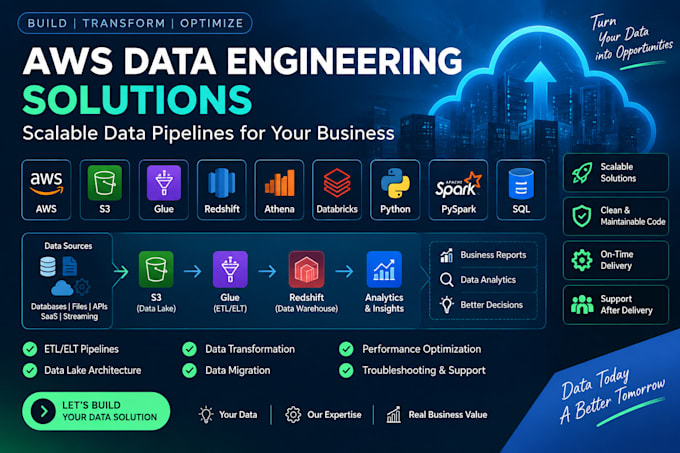
Stai cercando un Data Engineer esperto per creare pipeline di dati affidabili e scalabili?
Svilupperò e ottimizzerò soluzioni di data engineering, ETL/ELT e processamento dati su AWS usando Python, PySpark, SQL, AWS Glue, S3, Redshift, Athena e Databricks.
Ecco come posso aiutarti:
Mi concentro sulla creazione di soluzioni di dati pulite, scalabili, manutenibili e pronte per la produzione in base alle tue esigenze di business.
Se hai bisogno di una nuova pipeline di dati, di ottimizzare un workflow esistente o di aiuto con il troubleshooting del tuo progetto di data engineering, posso aiutarti.
Tecnologie: AWS | Python | PySpark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Expertise:
CI/CD
•
Monitoraggio e registrazione
•
Automazione
Provider Cloud:
Amazon Web Services
