Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Specialista in pipeline di dati LLM
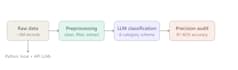
Hai bisogno di trasformare dati di testo non strutturati in categorie pulite e etichettate? Progetto e costruisco pipeline di classificazione usando grandi modelli linguistici (locali o API-based) e Python, testate su scala in un progetto che processa circa 3 milioni di record di testo.
Ciò che offro:
- Schemi di classificazione del testo personalizzati in base alle tue categorie
- Etichettatura basata su LLM (modelli locali come Llama, o API come DeepInfra/OpenAI)
- Pipeline di pulizia e preprocessing dei dati in Python
- Verifica dell'accuratezza per farti sapere quanto sono affidabili i risultati
- Documentazione chiara della metodologia e dei risultati
Perché lavorare con me:
Ricercatore MSc (Taipei Medical University, GPA 4.0) con esperienza pratica nella creazione e validazione di sistemi di classificazione su larga scala. Mi interessa l'accuratezza, non solo la velocità. Ogni pipeline che costruisco include una fase di validazione, così puoi fidarti dell'output.
Inviami i tuoi dati e le categorie, e definirò l'approccio giusto per il tuo progetto.