Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Analisi dati AbyssalAnalytics da un collega biologo
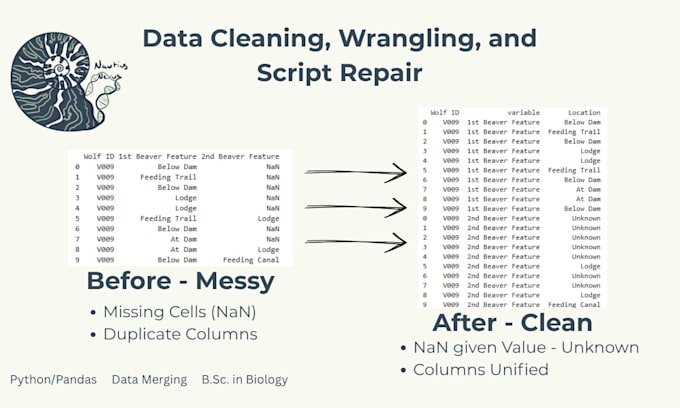
Sei uno studente universitario, ricercatore o accademico che lotta con codice rotto o un dataset disordinato? Come analista dati con una laurea in Biologia e un minore in Scienze Psicologiche, capisco che i tuoi dati rappresentano ore di osservazioni meticolose e lavoro fisico, e non sono solo fogli di calcolo aziendali. Mi specializzo nell’esecuzione meccanica della pulizia dei dati così puoi concentrarti interamente sulla tua tesi, sulle linee guida del comitato o su altre questioni urgenti.
Cosa Faccio:
Debug di codice: eliminare errori di sintassi, loop o avvisi di layout nei tuoi Jupyter Notebook.
Data Wrangling: ristrutturare formati grezzi, gestire celle mancanti e normalizzare le categorie di testo.
Integrazione multi-flusso: sincronizzare fino a 3 log o fogli di calcolo separati in un unico set di dati unificato.
Nota: per proteggere l'integrità dei dati, il tuo file grezzo e le ipotesi di ricerca sono congelati non appena l’ordine parte.
Per set di dati massivi che superano le soglie di righe di base, applica l’extra 'Extra Data or File' al checkout. Per un notebook del progetto aggiuntivo, scegli lo stesso. Se vuoi una spiegazione del codice, seleziona 'Code Documentation'.
Consulta il mio codice pubblico su github.com/skyegambrel
Traduzione automatica.
Quali formati di file accetti per la pulizia dei dati?
Accetto formati di dati tabulari standard tra cui CSV, XLSX (Excel), TSV e TXT, così come file di script Jupyter Notebook (.ipynb) per debug. Assicurati che le strutture dei tuoi file siano non criptate prima di caricarli nel pannello requisiti.
Cosa si intende per una singola “Item Cleaned” o file dati?
Un singolo item si riferisce a un singolo foglio di calcolo, tabella dati o notebook sorgente. Il Tier 1 copre un singolo script rotto, il Tier 2 copre un singolo file di dati grezzi (fino a 200 righe) e il Tier 3 copre la pulizia e l’integrazione strutturale di fino a 3 file separati.
Come gestisci valori mancanti, celle vuote o NaN nel mio dataset?
• Utilizzo librerie Python specializzate (Pandas e NumPy) per isolare schemi di dati mancanti. In base alle tue istruzioni esplicite, scriverò pipeline pulite per rimuovere righe vuote, isolare vuoti strutturali o imputare categorie mancanti in base ai requisiti del progetto—senza invenzioni.
Spiegherai il codice Python o le librerie che hai usato per pulire i miei file?
I livelli base forniscono i dati puliti e lo script annotato. Se vuoi una spiegazione completa, parola-per-parola in inglese semplice delle funzioni Pandas usate, in modo da poter difendere facilmente la pipeline dati al tuo comitato, seleziona l’extra "Code Documentation" al checkout.
Firma NDA o clausole di riservatezza sui dati?
Secondo le regole severe e sicure di Fiverr, i tuoi file sorgente grezzi, note di osservazione e ipotesi sono considerati proprietà intellettuale strettamente riservate e non sono mai condivisi o pubblicati.
