Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dei dati
Hai bisogno di un Senior Data Engineer per pipeline ETL/ELT scalabili, elaborazione di Big Data, Data Warehousing o architetture Lakehouse?
Sono Muhammad Ahmed, un Data Engineer con oltre 4 anni di esperienza nella creazione di piattaforme di dati di livello enterprise su AWS, Azure, GCP e Snowflake.
Servizi che offro:
Tecnologie:
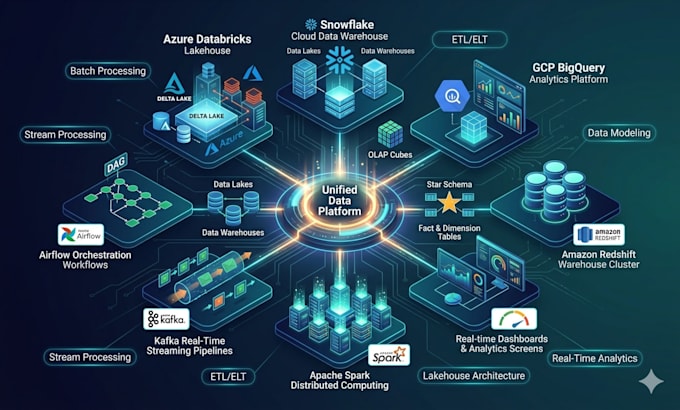
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Costruisco soluzioni di data engineering scalabili, affidabili e native del cloud per analytics, reporting, automazione e elaborazione in tempo reale. E fornisco dati pronti per AI/ML e analytics.
Data Engineering, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, Data Warehouse, Redshift, BigQuery.
Warehouse Platform:
Snowflake
•
BigQuery
•
Databricks
Tipo di progetto:
New Build
Traduzione automatica.
Quali piattaforme cloud supportate?
Lavoro con AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift e BigQuery.
Costruisci pipeline batch e streaming?
Sì. Sviluppo pipeline batch usando Apache Spark e soluzioni di streaming con Kafka e Spark Streaming.
Puoi progettare architetture di Data Warehouse e Lakehouse?
Sì. Progetto Data Lakes, Data Warehouse e sistemi Lakehouse scalabili usando Medallion Architecture e piattaforme cloud moderne.
Quali strumenti di orchestrazione usi?
Apache Airflow, Snowflake Tasks / lavori programmati e soluzioni di scheduling native del cloud.
Implementi modellazione dei dati?
Sì. Lavoro con schema star, snowflake, dimensioni, fact tables, OLAP e OLTP.
Quali tecnologie usi per l'elaborazione dei dati?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka e strumenti di elaborazione nativi del cloud.
Puoi ottimizzare pipeline esistenti?
Sì. Posso migliorare le prestazioni, la scalabilità, l'ottimizzazione dei costi e l'affidabilità dei sistemi di data engineering esistenti.