Costruirò scraper web personalizzati in python e automatizzerò l'estrazione dei dati
A
A
Albert P
Alcune informazioni sono state tradotte automaticamente.
Schermo intero
Informazioni su questo servizio
Traduzione automatica.
Hai bisogno di una pipeline dati affidabile e automatizzata per semplificare le operazioni della tua azienda? Posso aiutarti!
Sono un Data Engineer professionista, esperto nel costruire pipeline ETL/ELT di produzione, integrazioni API e soluzioni di automazione dei dati usando Python, SQL e tecnologie cloud.
Cosa posso fare per te:
ETL/ELT pipelines: estrarre, trasformare e caricare i dati da API, database, file e storage cloud.
Integrazioni API: collegare servizi di terze parti e automatizzare i trasferimenti di dati.
Automazione dei dati: costruire workflow pianificati, sincronizzazione dei dati e pipeline guidate dagli eventi.
Web scraping: raccogliere e processare dati da siti web e altre fonti online.
Cloud data engineering: costruire soluzioni usando AWS, S3, Redshift e altri servizi cloud.
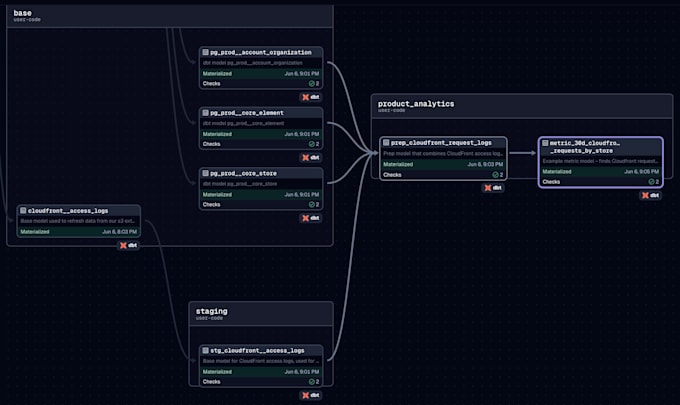
Trasformazione dei dati: pulire, validare e trasformare dati grezzi con Python, SQL e dbt.
Monitoraggio e affidabilità: implementare logging, gestione degli errori, meccanismi di retry e notifiche.
Integrazione AI: integrare LLM e elaborazione guidata dall’AI nei tuoi flussi di lavoro sui dati.
Tecnologie con cui lavoro: Python, SQL, PostgreSQL, AWS, Redshift, dbt, Dagster, Apache Airflow, REST API, Docker e altro.
Perché lavorare con me? Ho esperienza pratica nello sviluppo di dati di produzione
Framework e strumenti per modelli IA
LangChain
n8n
Google Gemini
Piattaforma
Discord
HubSpot CRM
Slack
Telegram
Tipo
Sincronizzazione dati
Automazione email
Automazione attività
Web scraping
Web Scraping e Inserimento dati
Punti integrazione automazione
Sito web
Fogli Google
Slack
Email
Linguaggio di programmazione
Bash
JavaScript
Python
TypeScript
HTML e CSS
Scopri di più su Albert P
Albert P
Data Engineer III
DaFilippine
Membro danov 2026
Lingue
Tagalog, Inglese
I am a Data Engineer with extensive experience in building LLM-powered research pipelines and migrating legacy fraud detection systems to modern stacks like dbt and Dagster. I specialize in developing config-driven delivery frameworks and optimizing high-volume data pipelines across AWS, Snowflake, and Redshift environments.