Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Senior Software Engineer POS, ERP e soluzioni web e mobile con intelligenza artificiale
Hai bisogno che il tuo LLM venga deployato in produzione, in modo rapido, ottimizzato e conveniente?
Sei nel posto giusto!
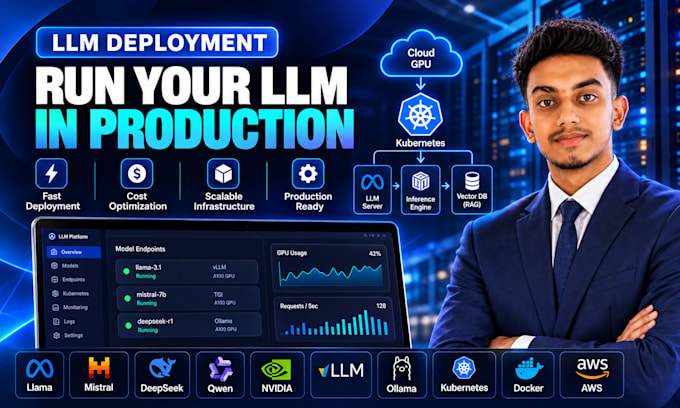
Deploio e configuro open-source LLM su server cloud con GPU e Kubernetes, con motori di inference ottimizzati per risposte veloci e costi GPU più bassi.
Ciò che offro:
Stack tecnologico:
Inference: vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modelli: Hugging Face || Llama || Mistral || Qwen || DeepSeek
Cloud & GPU: AWS || Google Cloud || Azure || RunPod || Lambda Labs
Container: Docker || Kubernetes || Helm
Monitoraggio: Prometheus || Grafana
Perché scegliermi?
Facciamo partire il tuo LLM oggi!
Traduzione automatica.
Quali LLM puoi distribuire?
Qualsiasi modello open-source da Hugging Face, inclusi Llama, Mistral, Qwen, DeepSeek, Gemma e Phi, così come modelli fine-tuned o personalizzati che fornisci.
Cosa include la configurazione del motore di inference?
Impostazione e ottimizzazione di vLLM, TGI, Triton o Ollama per il tuo modello: memoria GPU, batching, lunghezza del contesto, KV cache, parallelismo tensoriale e quantizzazione, per risposte più veloci a costi più bassi.
Quale motore di inference dovrei usare?
vLLM per API ad alta capacità, TGI per modelli Hugging Face, Triton o TensorRT-LLM per le massime performance NVIDIA GPU, e Ollama o llama.cpp per setup più piccoli o CPU. Ti consiglierò la soluzione migliore.
Puoi ridurre i costi della GPU?
Sì. Tramite quantizzazione (AWQ, GPTQ, GGUF), batching e dimensionamento corretto delle GPU, posso spesso far girare lo stesso modello su hardware più economico con qualità simile.
L'API funzionerà come quella di OpenAI?
Sì. Posso configurare un endpoint API compatibile con OpenAI, così puoi passare dalla tua app attuale OpenAI al tuo LLM semplicemente cambiando URL di base e API key.
Chi paga i costi di GPU e cloud?
I costi di GPU e hosting sono fatturati dal provider (AWS, GCP, Azure, RunPod, ecc.) al tuo account. Ti aiuterò a scegliere la GPU più conveniente per il tuo modello e traffico.
Il mio modello e i dati sono privati?
Sì. Il tuo LLM gira sui tuoi server, quindi prompt e dati non vanno mai a terze parti. Proteggo anche l'endpoint con API key, SSL e regole firewall. Posso firmare NDA se necessario.
Cosa devo fornire prima di iniziare?
Sì. Condividi i pesi del modello o il repo Hugging Face, e lo deployerò e ottimizzerò con il motore di inference più adatto.
Puoi distribuire un modello che ho perfezionato?
Scrivimi prima di ordinare. Valuterò le tue esigenze di modello e traffico e ti consiglierò il pacchetto giusto o ti invierò un'offerta personalizzata.
Non sei sicuro di quale pacchetto sia adatto al tuo progetto?
Scrivimi prima di ordinare. Valuterò il tuo modello e le esigenze di traffico e ti consiglierò il pacchetto giusto o ti invierò un'offerta personalizzata.
