Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Level 2


Traduzione automatica.
FINE-TUNING PERSONALIZZATO DI LLM
I modelli AI generici possono creare allucinazioni o fallire nei tuoi flussi di lavoro aziendali. Personalizzali con i tuoi dati proprietari, formattazione e conoscenza del dominio.
CONSEGNE & VELOCITÀ
LA SOLUZIONE
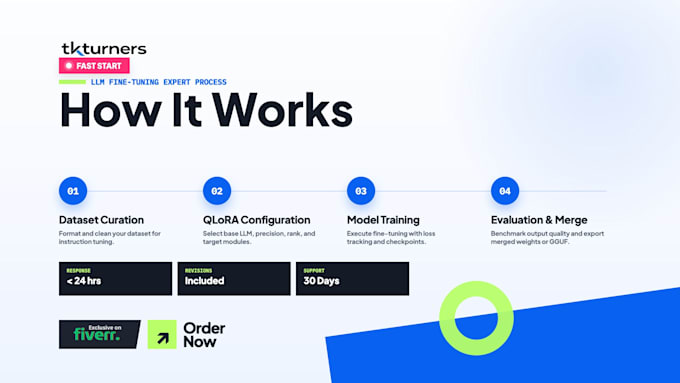
Costruiamo dataset di istruzioni puliti, ottimizziamo parametri rank/alpha e personalizziamo i modelli per migliorare le prestazioni nel dominio e ridurre i costi di inferenza.
PERCHÉ TKTURNERS
Ingegneri AI full-stack che consegnano modelli pronti per la produzione e automazione dei workflow su misura per le tue esigenze aziendali.
GARANZIA DI QUALITÀ
Ogni modello viene valutato con prompt di test concordati. Se i risultati non raggiungono le metriche target, riaddestriamo senza costo aggiuntivo.
AUDIT AI GRATUITO
Contattaci prima di ordinare per un audit gratuito di 15 minuti sul dataset e una raccomandazione sull'architettura del modello.
Senior Software Engineer
Level 2
Lingue
Traduzione automatica.
Traduzione automatica.
Perché dovrei inviarti un messaggio prima di ordinare?
Contattarci in anticipo ci permette di valutare la dimensione del tuo dataset, verificare la compatibilità con il modello di base (ad esempio Llama 3, Mistral) e confermare i requisiti di calcolo, così riceverai il pacchetto giusto.
Quali architetture di base LLM supporti per il fine-tuning?
Supportiamo Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon e qualsiasi modello open-weights personalizzato ospitato su Hugging Face.
Qual è la differenza tra LoRA e QLoRA?
LoRA addestra matrici di adattatori a basso rango per adattare efficacemente un modello. QLoRA quantizza il modello di base a 4-bit durante l'addestramento, riducendo drasticamente i requisiti di VRAM GPU mantenendo la massima precisione del modello.
Chi copre i costi di calcolo GPU e infrastruttura cloud?
I costi di calcolo (RunPod, Lambda Labs, Google Colab Pro o Hugging Face Inference Endpoints) sono a carico del cliente. Ti guidiamo verso la configurazione GPU più economica.
In quale formato devo fornire il mio dataset?
Puoi fornire i tuoi dati in JSON, JSONL, CSV o testo grezzo. Li puliamo, validiamo e convertiamo in formati di istruzioni standard come Alpaca, ShareGPT o ChatML.
Quali consegne riceverò al termine del progetto?
Riceverai i pesi dell'adattatore LoRA addestrato, il modello standalone unito (se richiesto), file GGUF quantizzati per Ollama/LM Studio, script di test e metriche di valutazione.
Puoi distribuire il modello fine-tuned su un'API o cloud privato?
Sì. Possiamo distribuire il tuo modello addestrato su Hugging Face Dedicated Endpoints, RunPod serverless, vLLM, Ollama o un backend FastAPI personalizzato su AWS/GCP.
Di quale accesso API o piattaforma di terze parti avrai bisogno?
Potremmo aver bisogno di accesso in lettura/scrittura al tuo account Hugging Face (token di accesso) e alla piattaforma cloud GPU scelta (RunPod, Lambda Labs o AWS) tramite API key o credenziali temporanee.
Come gestisci le revisioni e le performance di benchmark?
Ogni livello include revisioni per regolare learning rate, epoche o parametri rank/alpha. Valutiamo il tuo modello con set di validazione per verificare la qualità.
Offrite supporto e manutenzione post-consegna?
Sì, offriamo supporto continuo e supporto retainer per l'ingestione periodica di dataset, retraining del modello e scalabilità dell'inferenza cloud.