Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Traduzione automatica.
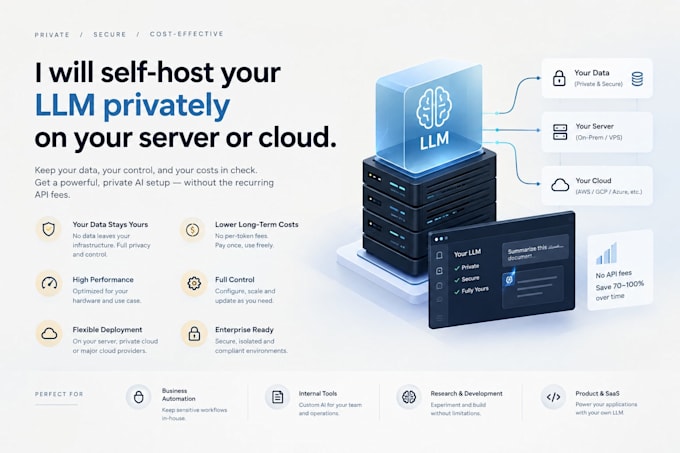
Auto-ospiterò il tuo LLM privatamente sul tuo server o cloud
Far passare il tuo LLM tramite un'API di terze parti significa che i tuoi prompt e dati attraversano i server di qualcun altro. Se hai bisogno di privacy dei dati, costi prevedibili o di un modello offline/air gapped, l'auto-ospitazione è la soluzione. La configuro dall'inizio alla fine.
Implemento modelli open-weight (Llama, Mistral, Qwen, DeepSeek, o il tuo modello personalizzato) sul tuo VPS, server dedicato o istanza cloud GPU (AWS, Vultr, RunPod, Lambda Labs), e li espongo tramite un endpoint API compatibile OpenAI che puoi collegare direttamente alla tua app.
Ciò che ottieni:
Ho configurato infrastrutture di produzione su AWS (ECS, EC2, IAM) e gestito workload Kubernetes con GPU prima, quindi non è il mio primo server.
AI Engineer and Automation Specialist I LangChain, RAG I React, Node, DevOps
Lingue
Traduzione automatica.
Traduzione automatica.
Ho bisogno del mio GPU personale?
No — posso aiutarti a provisioningare un'istanza cloud GPU se non ne hai una (il costo è separato dal prezzo del servizio).
Puoi fare il fine-tuning del modello?
È un servizio separato — questa gig copre il deployment/hosting di un modello esistente o open-weight.
I miei dati sono davvero privati?
Sì — una volta deployato, tutte le inferenze vengono eseguite sulla tua infrastruttura; niente viene inviato a un'API di terze parti.
