Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Sviluppatore web Full Stack: WordPress, OCR, integrazione API, siti web di peptidi
Hai bisogno di automatizzare il tracciamento visivo, estrarre dati o lanciare un'app di AI?
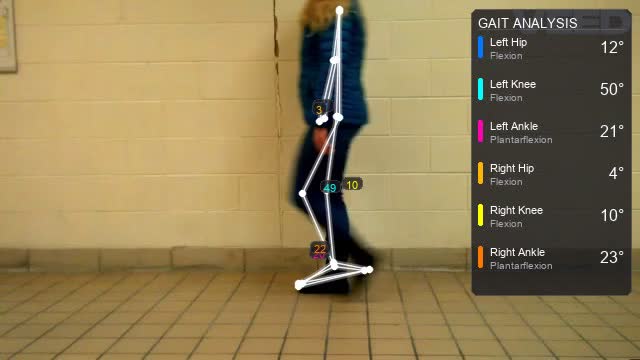
L'analisi manuale di video e la gestione di documenti richiedono tempo alla tua attività. Costruisco sistemi di AI computer vision e OCR ad alte prestazioni per risolvere i tuoi colli di bottiglia e trasformare i dati visivi in insight pratici.
Sia che tu abbia bisogno di una app di computer vision o rilevamento oggetti autonoma o di una pipeline di estrazione dati, consegno software robusto, pronto per il deployment e personalizzato al tuo workflow.
PROBLEMI CHE RISOLVO:
TECH STACKS & STRUMENTI:
PERCHÉ SCEGLIERE QUESTO GIG?
Contattami prima di ordinare per discutere il tuo dataset!
Linguaggio di programmazione:
Python
•
MATLAB
•
SQL
•
Colab
•
MLflow
Framework:
Scikit-learn
•
Google ML Kit
•
SimpleCV
•
PyTorch
•
Panda
Traduzione automatica.
Cosa devo fornire per iniziare a costruire la mia app di computer vision o rilevamento oggetti?
Fornisci il tuo dataset (immagini, video o scansioni di documenti) e una spiegazione chiara di quali oggetti o testi vuoi che il sistema di AI computer vision e OCR tracci o estragga. Se non hai ancora dati, posso aiutarti con la raccolta e l'impostazione di framework personalizzati.
Quali framework e modelli di deep learning usi per lo sviluppo?
Scrivo principalmente script Python di AI puliti che utilizzano OpenCV per flussi video in tempo reale, insieme a PyTorch e TensorFlow per l'addestramento dei modelli. Per alta velocità e precisione, implemento architetture all'avanguardia come YOLOv8 e YOLOv11 per garantire risultati di alta qualità.
Il tuo sistema OCR può gestire testo scritto a mano o documenti complessi?
Sì, il sistema OCR intelligente è configurato con motori robusti (come Tesseract, EasyOCR o API di visione cloud) adattati a leggere layout multi-colonna, fatture digitali e campi di testo complessi, convertendo i file grezzi in pipeline di dati strutturati e ricercabili.
L'app finale funzionerà localmente o può essere distribuita nel cloud?
Entrambe! A seconda delle tue esigenze, posso consegnare la soluzione come strumento desktop leggero, impacchettarla in container Docker per server cloud (AWS/GCP) o costruire un'interfaccia di app web AI completamente interattiva usando strumenti moderni come Streamlit.
Come garantisci l'accuratezza del tracciamento oggetti e della segmentazione delle immagini?
Ogni pipeline viene sottoposta a test di validazione rigorosi usando metriche di valutazione di machine learning personalizzate. Regolo con attenzione le soglie di confidenza, elimino falsi positivi e perfeziono le maschere di segmentazione fino a raggiungere la precisione richiesta in produzione.