Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Traduzione automatica.
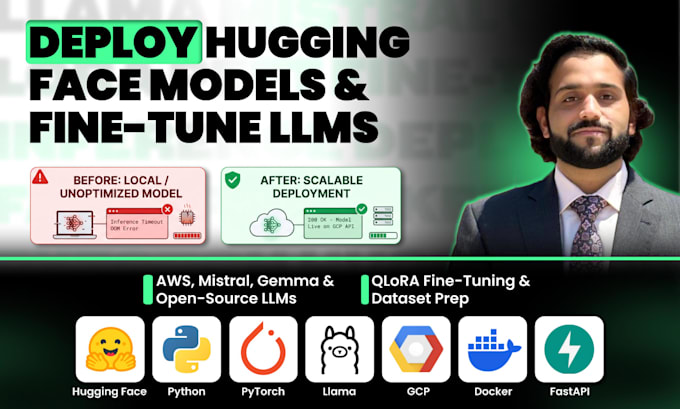
Cerchi di deployare o fare fine-tuning di LLM open-source come Llama 3, Mistral o Gemma sulla tua infrastruttura cloud?
Sono specializzato in integrazione personalizzata di modelli Hugging Face, QLoRA fine-tuning, containerizzazione e deploy pronti per la produzione su GCP, AWS e endpoint di inference.
Ciò che offro:
Stack tecnologico: Hugging Face Transformers, PEFT/LoRA, PyTorch, Llama 3, Mistral, Gemma, GCP Vertex AI, Docker, FastAPI, Python.
Perché scegliere me?
Contattami prima di ordinare per discutere i parametri del modello e la configurazione del cloud!
AI and Machine Learning Engineer
Lingue
Traduzione automatica.
Traduzione automatica.
1. Quali LLM open-source puoi fare fine-tuning o deployare?
Lavoro con tutte le principali architetture open-source ospitate su Hugging Face, tra cui Llama 3/3.1, Mistral, Mixtral, Gemma 1/2, DeepSeek, Falcon e Qwen.
2. Dove puoi deployare i modelli Hugging Face fine-tuned?
Posso deployare i tuoi modelli su GCP (Vertex AI, Compute Engine), AWS (SageMaker, EC2), Azure, Hugging Face Inference Endpoints, RunPod o server GPU locali usando container Docker.
3. Quali tecniche di fine-tuning usi per ridurre i costi?
Mi specializzo in metodi PEFT come QLoRA e LoRA usando PyTorch e Hugging Face Transformers. Questo riduce drasticamente i requisiti di VRAM GPU e i costi di training mantenendo alte prestazioni del modello.
4. Otterrò un endpoint API utilizzabile per interrogare il mio modello?
Sì! Per i pacchetti Standard e Premium, avvolgo il modello in un servizio web ad alte prestazioni con FastAPI o Flask, con endpoint pronti da integrare nella tua app web, mobile o workflow backend.
5. Come gestiamo trasferimenti di grandi dataset e permessi cloud?
Puoi condividere il tuo dataset tramite storage cloud sicuro (Google Drive, S3, Hugging Face Datasets). Per deploy cloud, puoi concedere accesso temporaneo tramite IAM senza condividere password di root.