Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA

Traduzione automatica.
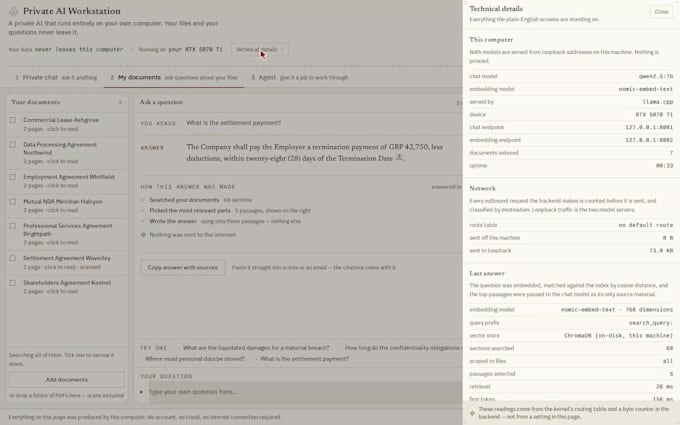
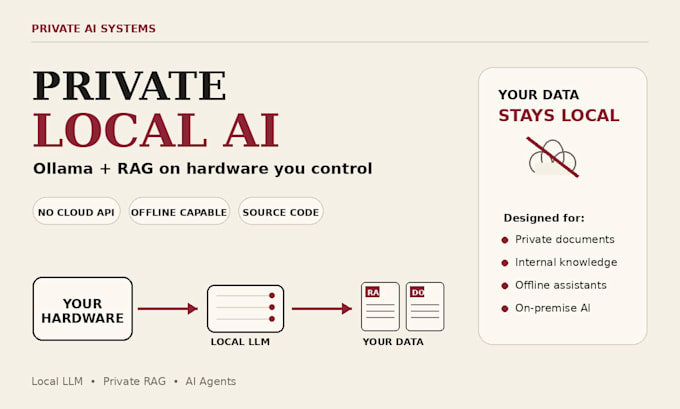
Gestisci un LLM privato locale su hardware che controlli tu senza inviare prompt, documenti o dati sensibili a API di modelli esterni.
Costruisco sistemi di intelligenza artificiale locali con Ollama, llama.cpp, RAG, database vettoriali e flussi di lavoro personalizzati per aziende e team che hanno bisogno di privacy.
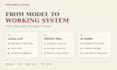
COSA POSSO IMPLEMENTARE
IDEALE PER
Basi di conoscenza interne, documenti riservati, operazioni legali/finanziarie, ricerca privata, assistenti offline e team che vogliono evitare costi ricorrenti di API AI cloud.
Il tuo sistema può essere configurato per eseguire inferenze e recupero di documenti interamente sul tuo computer o rete privata.
Scrivimi prima di ordinare con il tuo OS, CPU, GPU/VRAM, RAM e caso d'uso desiderato così posso confermare il modello e il pacchetto più adatti.
Local AI Developer
Lingue
Traduzione automatica.
Traduzione automatica.
Ho bisogno di un computer potente per farlo funzionare?
Dipende dal modello e dal carico di lavoro. È consigliato usare una GPU NVIDIA dedicata con abbastanza VRAM per un'inferenza più veloce, ma anche modelli più piccoli possono funzionare su CPU e Mac con Apple Silicon. Mandami le specifiche della tua CPU, GPU/VRAM, RAM e il caso d'uso e ti consiglierò una configurazione realistica.
Serve una connessione internet attiva per funzionare?
Per il sistema locale principale non serve connessione internet una volta installati i modelli e le dipendenze necessarie. Le integrazioni esterne opzionali potrebbero richiedere accesso alla rete.
I miei prompt e documenti verranno inviati a un'API AI esterna?
La configurazione può essere impostata in modo che inferenza e recupero di documenti avvengano sul tuo computer o sulla tua rete privata senza inviare prompt o documenti a API di modelli esterni.
Quali documenti può usare il sistema RAG?
Le fonti tipiche includono PDF, DOCX, TXT, CSV e contenuti strutturati di knowledge-base. Chiedi prima se hai PDF scannerizzati, formati insoliti o un grande database esistente.
Ricevo il codice sorgente e i file di configurazione?
Sì, per codice personalizzato creato per il tuo progetto. Il software di terze parti e i modelli rimangono soggetti alle loro licenze. Includo anche la configurazione concordata e la documentazione di consegna.
Puoi renderlo completamente air-gapped?
Sì, quando il software scelto, i file del modello e il tuo ambiente supportano una distribuzione air-gapped. Comunica questa esigenza prima di ordinare in modo che il scope includa la gestione delle dipendenze offline.
Puoi installarlo su Windows, Linux, macOS o su un server?
Sì, a seconda dell'hardware e dello stack scelto. Sistemi Apple Silicon, GPU NVIDIA, macchine CPU-only e setup VPS/server possono essere supportati con diverse scelte di modello.
È incluso il fine-tuning o l'addestramento del modello?
No, di default no. Questo servizio si concentra su deployment, RAG, integrazione e workflow di agent locali. Il fine-tuning è un scope separato e va discusso prima di ordinare.
Come lo distribuisci sul mio hardware?
Fornisco i file del progetto e i passaggi di deployment e posso guidarti nella configurazione tramite comunicazione su Fiverr. Il metodo preciso dipende dal tuo ambiente e dalle restrizioni di accesso.
Cosa devo inviare prima di ordinare?
Dal tuo OS, modello di CPU e GPU e VRAM, RAM, spazio di archiviazione disponibile, caso d'uso, tipi di documenti/dati, interfaccia preferita e se richiedi operazioni offline o air-gapped.