Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Traduzione automatica.
La maggior parte dei "chatbot RAG" su Fiverr vengono consegnati come demo:
un PDF, chunking debole, nessuna valutazione di retrieval, allucinazioni ovunque. Io costruisco sistemi RAG di livello produzione progettati per essere citati, valutati, monitorati.
COSA COSTRUIRÒ:
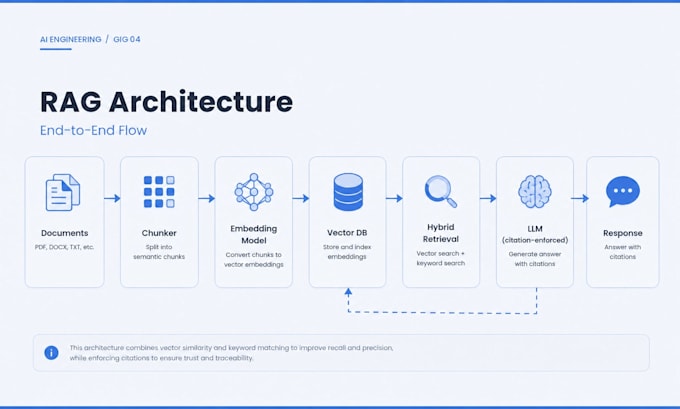
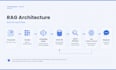
Architettura RAG personalizzata (LangChain, LlamaIndex, o Python puro) Configurazione database vettoriale (Pinecone, Qdrant, Weaviate, pgvector, Chroma) Pipeline di smart chunking + embedding (OpenAI, Cohere, BGE) Ricerca ibrida densa + sparsa + reranking per un effettivo recall@k Applicazione delle citazioni che collegano ogni affermazione a una fonte Chunk orchestrazione multi-modello (Claude, GPT-4o/5, Gemini) Framework di valutazione (Ragas, valutazioni personalizzate) che funziona Osservabilità (LangSmith o logging personalizzato) Endpoint API FastAPI / Node pronto per la tua app Self-hosted (Docker, il tuo VPS) o gestito (Pinecone)
CHI È IL MIO PUBBLICO:
Fondatori di SaaS che aggiungono ricerca AI / Q&A Team di sviluppo che necessita di RAG che funzioni in produzione Basi di conoscenza interne (Notion, Confluence, S3) Startup che sostituiscono la ricerca per parole chiave con quella semantica
PERCHÉ ASSUMERMI:
RAG che non hallucina, valutato, citato, monitorato Codice ben documentato e facile da mantenere per il tuo team Risposta in 1 ora Invia i tuoi documenti + caso d'uso. Piano scoping in 1 ora.
AI Voice Agent Developer, Vapi, Bland AI, Twilio, GPT4o
Lingue
Traduzione automatica.
Traduzione automatica.
Qual è la differenza tra un "demo RAG" e un "RAG di produzione"?
Un demo RAG integra un PDF, recupera i chunk top-k e utilizza un LLM — funziona con documenti tutorial ma si rompe con dati reali. Un RAG di produzione ha chunking intelligente adattato al tuo dominio, retrieval ibrido (non solo similarità coseno), reranking, enforcement delle citazioni, valutazioni rispetto a Q di ground-truth.
Quale database vettoriale dovrei usare — Pinecone, Qdrant, Weaviate o pgvector?
Pinecone è il più rapido da deployare (gestito, zero operazioni) — ottimo se vuoi consegnare in pochi giorni. Qdrant self-hosted è l'opzione gratuita migliore che scala. Weaviate è forte sulla ricerca ibrida con filtraggio dei metadati. pgvector è ideale se hai già Postgres e vuoi vettori accanto ai tuoi dati relazionali.
Come eviti le allucinazioni?
Tre livelli. (1) Enforcement delle citazioni — l'LLM deve citare il chunk recuperato per ogni affermazione, e le uscite senza citazioni vengono segnalate. (2) Validazione del retrieval — punteggi di confidenza sul retrieval, così le domande a bassa confidenza restituiscono "Non ho abbastanza informazioni" invece di indovinare. (3) Cross-mo
Puoi self-hostare l'intero sistema sulla mia infrastruttura?
Sì. Configurazione completa con Docker compose: Qdrant o Weaviate per i vettori, FastAPI per il servizio, il tuo endpoint LLM preferito (API OpenAI, API Anthropic, o Llama/Mistral self-hosted tramite Ollama o vLLM). Utile se hai vincoli di conformità o non vuoi dipendere da un fornitore. Incluso dal livello Standard in su.