Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Professionista senior in Data AI
Pagine web disordinate, feed o account Instagram trasformati in una tabella pulita, deduplicata, interrogabile, aggiornata secondo una pianificazione, con una dashboard o API sopra.
La differenza rispetto a uno scraper semplice: un passaggio AI legge ogni elemento e riempie i campi che le regex non possono, come categoria, intervallo di prezzo, sentiment, entità o la data dell'evento nascosta in una didascalia. L'output viene validato rispetto allo schema prima di toccare il database, così risposte malformate falliscono rumorosamente invece di inquinare i tuoi dati.
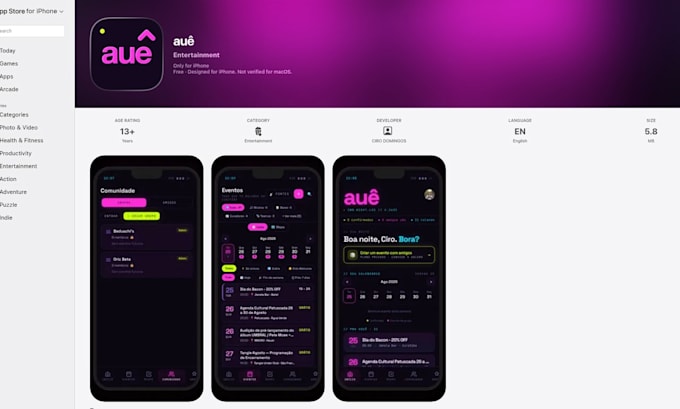
Prova: la mia app eventi raccoglie circa 80 account Instagram tramite Apify e usa Claude per estrarre i campi degli eventi da post e immagini ogni giorno. Il mio scraper di brand fa lo stesso per attributi di marca. Entrambi i link sono sul mio profilo.
Ciò che ottieni: la pipeline deployata su Railway o sul tuo host, la tabella in SQLite o Postgres, una dashboard Streamlit o un endpoint FastAPI, e il costo di ogni esecuzione registrato.
Come iniziamo: invia due pagine di esempio e le colonne che desideri. Riceverai una tabella di esempio di 100 righe prima dell'esecuzione completa.
Non incluso: siti che vietano lo scraping nei loro termini, login, captcha.
Tecnologia:
Python
•
Fogli Google
•
selenium
•
Playwright
•
Pandas
Tecnica:
Automatizzato
Traduzione automatica.
Può funzionare sul mio server?
Sì, oppure su Railway sotto il tuo account.
Quanto costa farlo funzionare?
Di solito sotto i 20$ al mese; ogni esecuzione registra il suo costo.