Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Traduzione automatica.
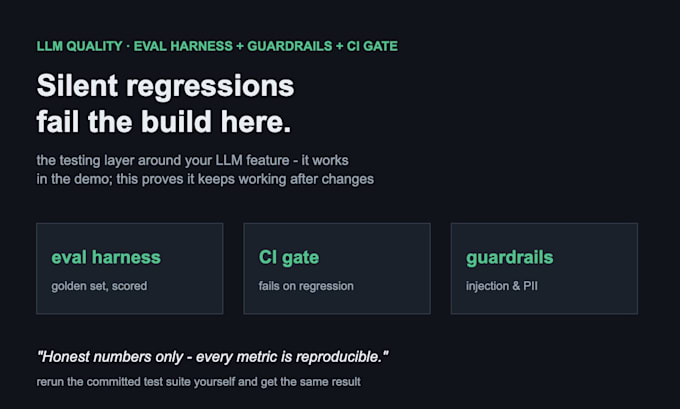
La tua app LLM funziona nella demo. La domanda è cosa viene consegnato agli utenti dopo il prossimo cambio di prompt - e la maggior parte dei team non ha modo di saperlo. È quello che costruisco: il livello di valutazione LLM per la tua funzionalità.
Ciò che ottieni:
Come lavoro: solo numeri onesti. Ogni metrica che riporto è riproducibile dai test case impegnati - puoi rieseguire tutto tu stesso. Se il tuo setup non ne trarrà beneficio, te lo dico prima che tu paghi, non dopo.
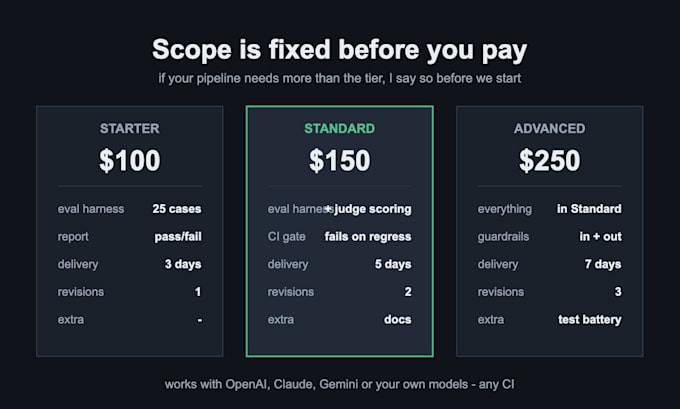
Funziona con OpenAI, Claude, Gemini o i tuoi modelli. Basato su Python, si integra con GitHub Actions o qualsiasi CI.
Data and Automation Engineer, Python, Web Tools, Clean Data
Lingue
Traduzione automatica.
Traduzione automatica.
Devo condividere le mie API keys o il codice?
Per Starter, no - posso costruire il harness contro input e output di esempio che fornisci. L’integrazione CI richiede accesso al repository o un sandbox. Le keys rimangono tue: usa una key di test limitata, o il tuo team esegue le chiamate live.
Quali modelli e framework supporti?
OpenAI, Claude, Gemini o i tuoi modelli. Il harness è semplice Python + Pytest, quindi funziona con qualsiasi stack e qualsiasi CI - GitHub Actions, GitLab CI, Jenkins. Nessun lock-in di framework.
Quali numeri otterrò realmente?
Pass/fail per ogni caso di test, punteggi aggregati per ogni esecuzione, e per i guardrails: tasso di blocco più tasso di falsi positivi su una batteria impegnata. Ogni numero è riproducibile - rifai la suite tu stesso e ottieni lo stesso risultato.