Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Senior DevOps e Network Security Engineer ed esperto di Linux
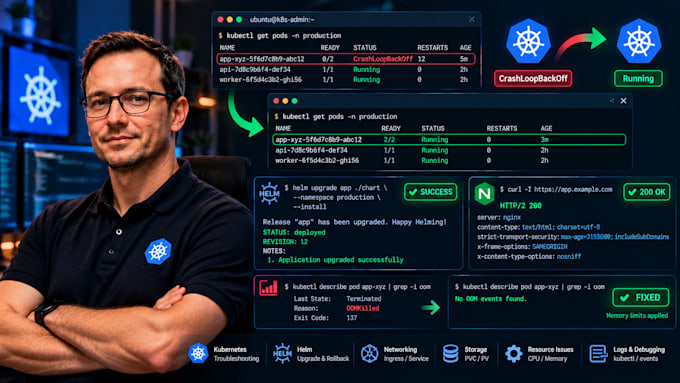
Pod di Kubernetes SOS in crash? Helm che fallisce? Rete rotta? Io risolvo in fretta.
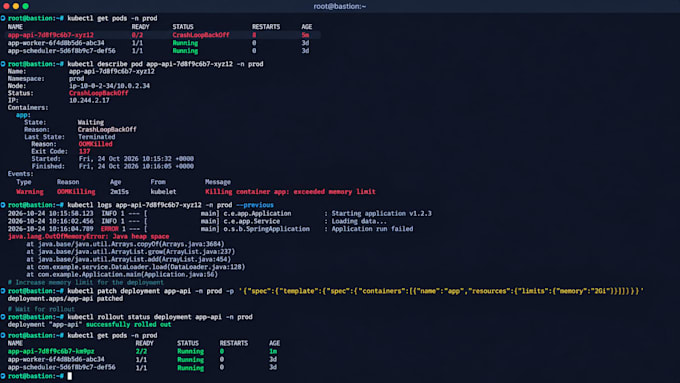
Sono un Platform/DevOps Engineer con oltre 5 anni di produzione K8s (EKS, GKE, AKS, bare-metal). Non indovino, uso un collaudato **debug playbook** (kubectl events logs metrics config) per trovare la causa principale in pochi minuti.
COSA RISOLVO (Ogni Pacchetto):
CrashLoopBackOff / OOMKilled (137) limiti di memoria, perdite, tuning runtime JVM/Go
ImagePullBackOff / ErrImagePull autorizzazioni ECR/GHCR/ACR, ruoli IAM, errori di battitura nelle tag delle immagini
Pending / Unschedulable quote delle risorse, selettori di nodo, taint/tolerations, binding PVC
Errore Helm chart missing dipendenze, mismatch di schema dei values, errori di template, release bloccato
Networking CNI (Calico/Cilium/Flannel), CoreDNS, Service/Ingress 502/504, NetworkPolicy
ConfigMap/Secret chiavi mancanti, namespace sbagliato, mount subPath, finalizers
Probe failure di liveness/readiness/startup tuning, HTTP vs exec vs gRPC
HPA/VPA non scala, metrics-server, metriche personalizzate, risorse vs metriche esterne


Traduzione automatica.
Come accedi in sicurezza al mio cluster?
Fornisci: kubeconfig con RBAC ristretto (get/list/watch pods, logs, events, helm releases) O accesso alla console cloud (EKS: aws eks update-kubeconfig, GKE: gcloud container clusters get-credentials, AKS: az aks get-credentials). Non chiedo mai admin/root.
E se il problema è nel codice della mia applicazione?
Lo identificherò ( stack trace, exit code, log) e ti dirò esattamente cosa correggere. Se vuoi che patchi l'immagine del container, è uno scope separato (scrivimi).
Puoi sistemare chart Helm scritti da qualcun altro?
Sì. Debuggerò la release (helm status, helm get values, helm template), correggerò values/dipendenze/template e testerò con helm upgrade --dry-run --debug.
Lavori nei weekend/notte per emergenze di produzione?
Sì. Mandami un messaggio con "URGENT" + fuso orario. Risponderò in meno di 30 minuti durante le ore di apertura (UTC+3). Sovrapprezzo emergenza: +50% (Base), +30% (Standard/Premium).