Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA

Traduzione automatica.
La tua funzione LLM ha superato la demo. Lo farà ancora dopo il prossimo prompt o cambiamento del modello?
Io costruisco suite di valutazione che rispondono a questa domanda. Otterrai una rubrica scritta per il tuo caso d'uso, un set di test con risposte attese e, se un LLM valuta i tuoi output, un controllo di quanto quel giudice sia affidabile.
Cosa ottieni:
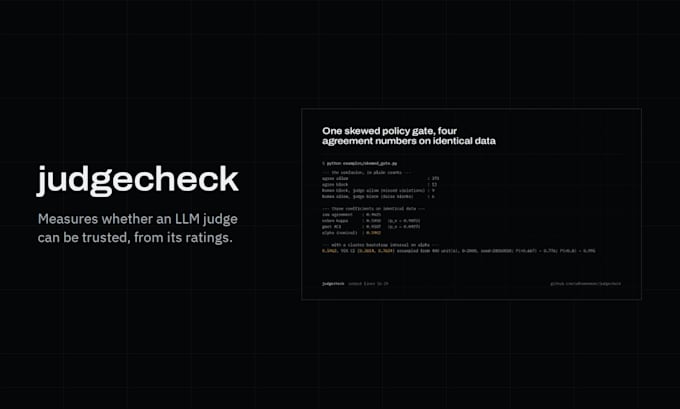
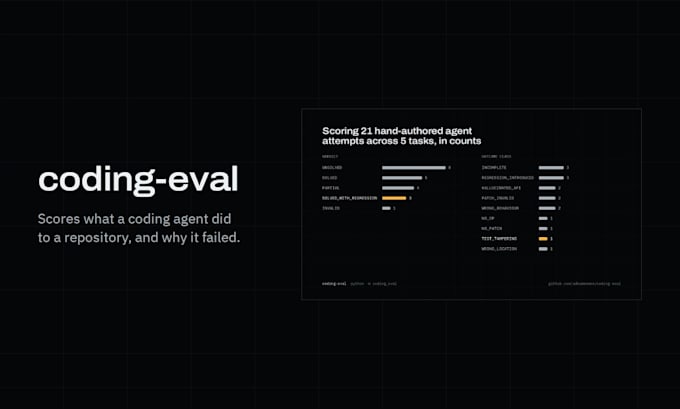
Perché io: ho costruito judgecheck, un rapporto di affidabilità per giudici LLM che mostra come il 96% di accordo grezzo possa nascondere punteggio corretto per fortuna fino a 0.60, e coding-eval, che riproduce tentativi di agenti di coding in sandbox (20 su 21 affermati successo; 5 riusciti). Valuto professionalmente il codice di frontier-model e costruisco strumenti di rubric e calibrazione per l'IA clinica araba.
Scrivimi cosa fa la funzionalità, alcuni input e output di esempio e che tipo di risposta consideri buona per te.
AI Red Teaming and LLM Evaluation Engineer
Lingue
Traduzione automatica.
Traduzione automatica.
Di cosa hai bisogno da me?
Accesso al modello o API che usi (o un file di output salvati), alcuni input reali di esempio e eventuali valutazioni umane che hai già. Se non ne hai, concordiamo insieme una breve sessione di valutazione.