Costruirò data pipeline scalabili usando pyspark, databricks e azure

Alcune informazioni sono state tradotte automaticamente.

India

Parlo Hindi, Inglese

Ingegnere dati senior

Sono un Senior Data Engineer con oltre 6 anni di esperienza nel progettare e ottimizzare pipeline dati scalabili su Azure e AWS. Mi specializzo in PySpark, Databricks e soluzioni ETL/ELT basate sul cl...
Informazioni su questo servizio

Hai problemi con query SQL lente, silos di dati disordinati o costi cloud alti? Sono un Enterprise Data Engineer (Microsoft Azure Certified) specializzato in PySpark, Azure Databricks, Delta Lake e SQL. Progetto, ottimizzo e costruisco architetture dati fault-tolerant che trasformano i dati grezzi in pipeline pronte per analytics e AI.

Ced Che Posso Fare Per Te:

  • Progettazione di pipeline ETL / ELT: pipeline batch e streaming scalabili usando PySpark, Databricks e Azure Data Factory (ADF).
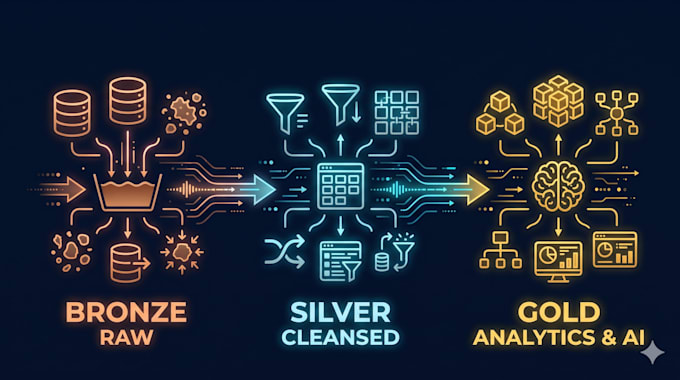
  • Architettura Medallion Lakehouse: strutturare dati grezzi in livelli Bronze, Silver e Gold su Delta Lake su ADLS Gen2.
  • Ottimizzazione prestazioni e costi: sistemare job Spark lenti, risolvere data skew, ottimizzare query Oracle/PostgreSQL e implementare Z-Ordering/Liquid Clustering.
  • AI e RAG Data Readiness: connettere lakehouse aziendali a database vettoriali (pgvector) e Kubernetes (AKS) per recupero AI in tempo reale.

Perché lavorare con me?

  • Codice modulare di livello produzione con diagrammi architetturali chiari.
  • Competenza profonda su Azure, Databricks, Python e database relazionali.
  • Comunicazione chiara e walkthrough post-consegna.

Contattami prima di ordinare così allineiamo stack dati e scope!

Lingua:

Inglese

•

Hindi

Esperienza tecnica:

Databricks

•

Snowflake

•

Google BigQuery

Expertise:

Pipeline dati

•

Sviluppo ETL

•

Data warehousing

Settore:

Audio e video

•

Analisi dei dati

•

Servizi finanziari