Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Laurea in Data Science e Intelligenza Artificiale
Pulizia e Preprocessing dei dati
La pulizia dei dati è una fase essenziale nel processo di analisi dei dati e di data science. Consiste nell’individuare, correggere e gestire dati inaccurati, incompleti, incoerenti o duplicati per migliorare la qualità e l’affidabilità di un dataset.
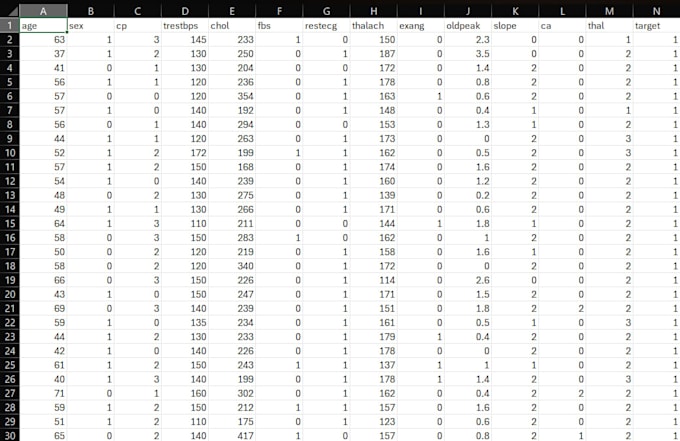
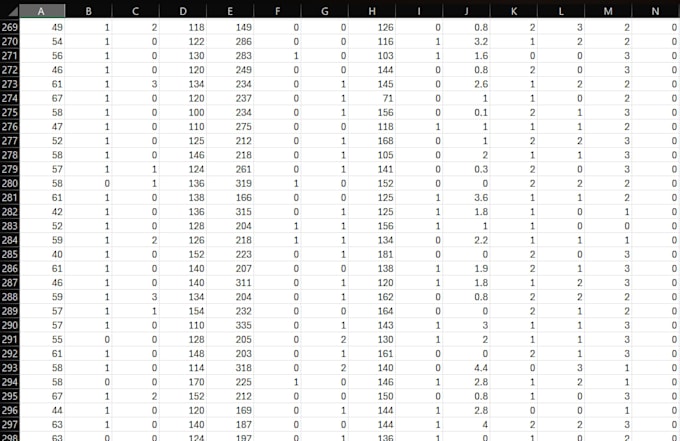
Il lavoro comprende comprendere il dataset, esplorarne la struttura, identificare valori mancanti, rimuovere record duplicati, gestire outlier, correggere formati dei dati incoerenti, sistemare tipi di dato errati e standardizzare i valori.
Coinvolge anche trasformare i dati grezzi in un formato strutturato e significativo in modo che possano essere usati efficacemente per ulteriori analisi, visualizzazioni e applicazioni di machine learning.
Attività chiave:
- Comprendere ed esplorare dataset grezzi.
- Identificare e gestire valori mancanti o nulli.
- Rimuovere record duplicati e non necessari.
- Individuare e trattare outlier.
- Correggere voci incoerenti e errori di formattazione.
- Convertire colonne nei tipi di dato appropriati.
- Standardizzare e trasformare i dati.
- Validare il dataset pulito per accuratezza e coerenza.
- Preparare dataset per analisi esplorative dei dati (EDA) e machine learning.