Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
1 ordine in coda


Traduzione automatica.
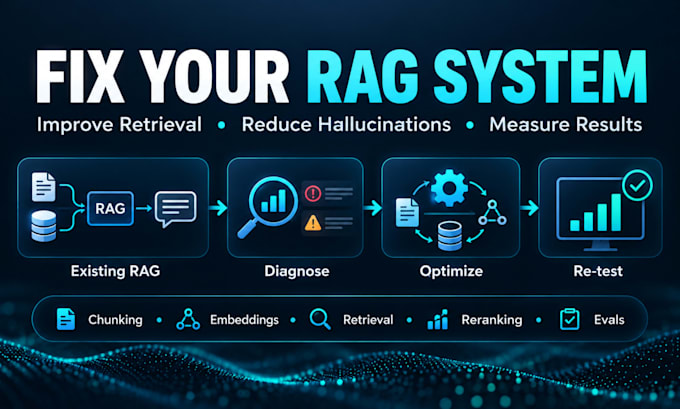
Il tuo sistema RAG recupera documenti sbagliati, hallucina, produce citazioni poco affidabili o risponde troppo lentamente?
Diagnosticherò e ottimizzerò il tuo pipeline RAG esistente usando test misurabili prima/dopo, non semplici modifiche casuali ai prompt.
Posso aiutarti a migliorare:
- Strategia di chunking
- Embeddings e ricerca vettoriale
- Precisione del recupero
- Filtraggio dei metadata
- Ricerca ibrida
- Reranking
- Costruzione di prompt e contesto
- Riduzione delle hallucination e ancoraggio
- Qualità delle citazioni
- Latency e uso dei token
- Prestazioni del database vettoriale
- Valutazione RAG
Il mio processo:
Misura -> Diagnosi -> Correzione -> Nuova verifica -> Confronto
Lavoro con sistemi RAG basati su Python, LangChain, LlamaIndex, FastAPI, OpenAI, Claude, LLM locali, Pinecone, Qdrant, Chroma, Weaviate, pgvector e stack simili.
Ricevi evidenze chiare di:
- Cosa ha causato il problema
- Cosa è stato modificato
- Come si è comportato il sistema prima e dopo
- Qualsiasi limite residuo
Questo servizio è per sistemi RAG esistenti. Per sistemi di produzione di grandi dimensioni, integrazioni multiple o ricostruzioni architetturali, contattami prima di ordinare.
AI and Data Science Engineer, RAG, MCP and LLM Automation
Lingue
Traduzione automatica.
Traduzione automatica.
1. Costruisci un nuovo sistema RAG da zero?
Questo servizio si concentra sulla diagnosi e il miglioramento di una pipeline RAG esistente. Lo sviluppo di un nuovo sistema dovrebbe essere gestito come un progetto personalizzato.
2. Puoi ridurre le hallucination?
Sì. Indago se le hallucination derivano dal retrieval, chunking, costruzione del contesto, prompt, citazioni o comportamento del modello e correggo la causa reale.
3. Puoi migliorare la precisione del retrieval?
Sì. Posso rivedere chunking, embeddings, ricerca vettoriale, filtri metadata, ricerca ibrida, reranking e impostazioni di retrieval.
4. Puoi lavorare con Pinecone, Qdrant, Chroma, Weaviate o pgvector?
Sì, a seconda dell'architettura attuale e dei requisiti del progetto.
5. Puoi ottimizzare latenza e costi API?
Sì. Latency, uso dei token, dimensione del contesto, chiamate inutili a LLM e efficienza del retrieval possono essere rivisti e ottimizzati.
6. Puoi garantire un miglioramento specifico della precisione?
No. Prima misuro la baseline attuale e poi riporto il miglioramento effettivo ottenuto su casi di test rappresentativi.
7. Di cosa hai bisogno da me per iniziare?
Per favore, fornisci il tuo codice sorgente o repository, l'architettura RAG attuale, il database vettoriale, il modello di embedding, alcuni documenti di esempio della knowledge-base, domande di test rappresentative e alcuni esempi dei fallimenti che vuoi correggere. Se hai risposte attese, log o risultati di valutazione, sono utili anche quelli