Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Sei pronto a portare il potere di LLM e AI personalizzata nella tua attività?
Sono uno sviluppatore software specializzato in integrazioni di Intelligenza Artificiale, architetture RAG (Retrieval-Augmented Generation) e applicazioni web moderne. Che tu abbia bisogno di una semplice API backend o di un'app di chat completa e personalizzata che interroga in modo sicuro i tuoi documenti, posso creare una soluzione robusta su misura per te.
Ciò che offro:
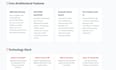
Sistemi RAG personalizzati: chat con i tuoi PDF, database o documenti aziendali usando LLM locali o cloud.
Backend & API: endpoint veloci, sicuri e scalabili costruiti con Python e FastAPI, completamente ottimizzati per lo streaming di token.
Soluzioni full-stack: interfacce frontend fluide e responsive sviluppate con React e TypeScript.
Deployment AI locale: configurazione di modelli locali orientati alla privacy usando Ollama e database vettoriali come Qdrant.
Il mio stack tecnologico:
Python, FastAPI, React, TypeScript, JavaScript, SQL, Ollama, Qdrant, Hugging Face.
Contattami prima di effettuare un ordine! Voglio capire le tue esigenze specifiche per assicurarci di scegliere l'approccio architetturale migliore per il tuo progetto.
AI Backend Engineer RAG Vector Search
Lingue
Traduzione automatica.
Traduzione automatica.
Perché dovrei scegliere un'architettura AI personalizzata rispetto a piattaforme commerciali generiche?
Una soluzione personalizzata ti dà piena proprietà e controllo. Invece di adattare i tuoi dati a un framework rigido, progettiamo una pipeline RAG su misura che si adatta esattamente alla tua logica aziendale, evitando il lock-in con i fornitori.
Come fa il sistema a leggere e cercare tra i miei documenti aziendali specifici?
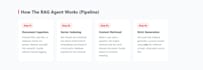
Integramo database vettoriali moderni come Qdrant per processare i tuoi PDF, database o testi aziendali. Questo permette al sistema di trovare immediatamente il contesto più rilevante in base al significato semantico, fornendo le informazioni giuste all'AI.
Come evitate che l'AI inventi fatti (hallucination)?
L'architettura utilizza un approccio RAG rigoroso. Il modello è vincolato a rispondere solo usando il contesto recuperato dai tuoi documenti verificati. Separiamo la logica rigorosa dalla generazione linguistica per garantire che i tuoi dati siano sempre accurati al 100%.
Può gestire dati aziendali altamente sensibili?
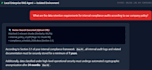
Assolutamente sì. Per la massima sicurezza, posso configurare deployment AI locali orientati alla privacy usando Ollama. Questo significa che i Large Language Models (LLMs) e i tuoi dati funzionano interamente sulla tua infrastruttura, assicurando che nulla venga mai inviato a API di terze parti.
Quali tecnologie usi per l'applicazione?
Il backend è alimentato da Python e FastAPI, che garantiscono endpoint veloci, scalabili e ottimizzati per lo streaming di token AI. Se hai bisogno di una soluzione full-stack, il frontend è costruito con React e TypeScript responsive.
Come iniziamo un nuovo progetto?
Contattami direttamente prima di effettuare un ordine. Discuteremo delle tue esigenze specifiche, dei tipi di dati e del caso d'uso per assicurarci di scegliere l'approccio architetturale più efficace per te.


