Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Stai cercando di aggiornare la tua applicazione con una ricerca semantica ad alte prestazioni, embedding vettoriali personalizzati e un confronto rapido di somiglianza?
Sono specializzato nella creazione di architetture di database vettoriali di livello produttivo, pipeline di ricerca semantica e algoritmi di somiglianza personalizzati usando Python, FastAPI, Qdrant e PostgreSQL (pgvector).
Ciò che offro:
Integrazione del database vettoriale: configurazione e ottimizzazione di Qdrant, PostgreSQL (pgvector), Chroma o FAISS.
Pipeline di embedding: suddivisione del testo, ottimizzazione dei token, modelli locali (SentenceTransformers, E5, BGE) o cloud (OpenAI).
Algoritmi di somiglianza personalizzati: calcolo di Cosine Similarity, Euclidean Distance e Dot Product.
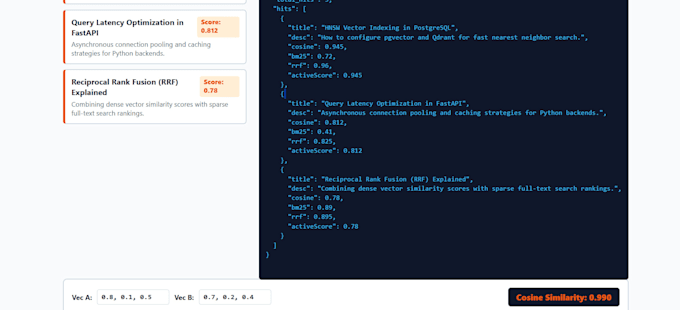
Ricerca ibrida: fusione della ricerca full-text tradizionale con il recupero di vettori densi usando Reciprocal Rank Fusion (RRF).
API di produzione: endpoint REST asincroni sviluppati con Python, FastAPI e validazione Pydantic.
Stack tecnologico:
Python, FastAPI, Qdrant, PostgreSQL (pgvector), SentenceTransformers, Hugging Face, PyTorch, Docker.
Contattami prima di effettuare un ordine per discutere il tuo dataset e le tue esigenze!
AI Backend Engineer RAG Vector Search
Lingue
Traduzione automatica.
Traduzione automatica.
Perché usare la Ricerca vettoriale invece del tradizionale confronto di parole chiave?
La ricerca tradizionale cerca corrispondenze esatte di parole. La ricerca vettoriale analizza il significato semantico, trovando contesti rilevanti anche quando gli utenti usano sinonimi o frasi diverse.
Può funzionare al 100% localmente per garantire la privacy totale dei dati?
Sì. Posso configurare modelli di embedding locali (come E5 o BGE tramite SentenceTransformers) e archivi vettoriali locali (Qdrant o pgvector) in modo che nessun dato lasci il tuo server.
Cos'è la Ricerca Ibrida e perché è migliore?
La Ricerca Ibrida combina la ricerca di vettori densi (significato semantico) con la ricerca di parole chiave sparse (BM25 o full-text di PostgreSQL) usando Reciprocal Rank Fusion (RRF) per la massima precisione.