Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
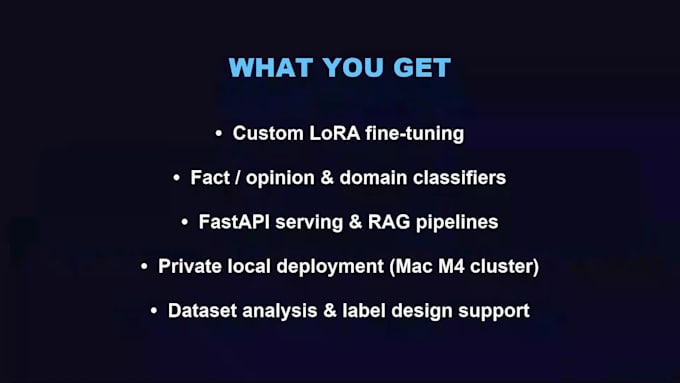
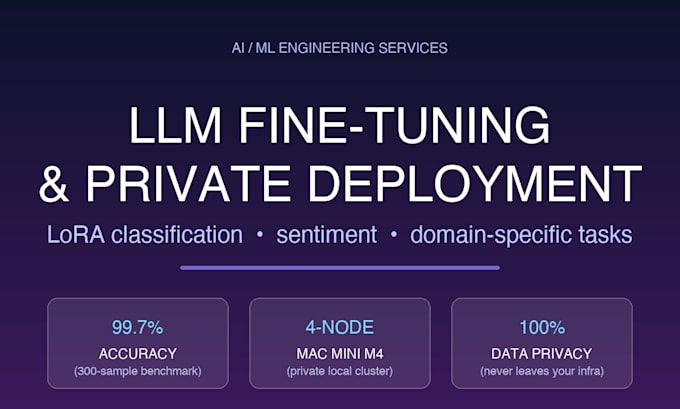
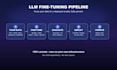
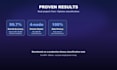
Personalizzazione di LLM con LoRA/QLoRA per classificazione, sentiment, trasferimento di stile e compiti specifici di dominio. Ho creato un classificatore binario di fatti/opinioni con Qwen3-14B-4bit LoRA che ha raggiunto il 99,7% di precisione, e tutto viene distribuito sul mio cluster privato di 4 nodi Mac Mini M4, così i tuoi dati non lasciano mai il tuo ambiente.
Ciò che offro:
Perché scegliermi:
Prima di ordinare: scrivimi con il tuo task, la dimensione e il formato del dataset, la lingua target e la scadenza, così posso confermare fattibilità e tempi di consegna.
AI ML Engineer, LLM Fine tuning and Private Deployment Specialist
Lingue
Traduzione automatica.
Traduzione automatica.
Di quali dati hai bisogno da me?
Campioni etichettati o non etichettati in CSV/JSON, o una descrizione del compito.
I miei dati resteranno privati?
Sì, tutto il lavoro avviene sul mio cluster privato locale, i dati non lasciano mai la tua infrastruttura.
Cosa riceverò dopo la consegna?
Pesi del modello fine-tuned, rapporto di valutazione e guida/deploy API se applicabile.
Quali modelli perfezioni?
Modelli open-source popolari come Qwen, Llama, Mistral e altri, usando LoRA/QLoRA efficiente.
Quanto tempo ci vorrà?
Compiti tipici di piccole o medie dimensioni vengono consegnati in 3-7 giorni, a seconda del volume di dati e del carico del cluster.
Puoi gestire dati testuali non in inglese?
Sì, posso affinare modelli multilingue come Qwen, BLOOM o MiniLM multilingue per compiti di classificazione e NLP in lingue diverse dall'inglese. Condividi la tua lingua e il tuo dominio e configurerò il modello giusto per te.
Quali opzioni di deployment offri?
Deployment privato tramite FastAPI + Docker (o MLX/vLLM per throughput in produzione) sui tuoi server, come Mac Mini, Linux o Windows. Ho anche configurato un endpoint API interno per il tuo team.
Quale precisione posso aspettarmi?
Dipende dalla qualità dei dati e dalla difficoltà del task. Come riferimento, il mio classificatore di fatti/opinioni con Qwen3-14B LoRA ha raggiunto il 99,7% di precisione. Ricevi sempre un rapporto completo con accuratezza, F1 e analisi degli errori.
Perché usare LoRA/QLoRA invece di un fine-tuning completo?
LoRA/QLoRA aggiorna solo una piccola parte dei parametri, riducendo i costi di training e l'uso di memoria fino al 90% mantenendo una qualità vicina a quella del fine-tuning completo. Si addestra più velocemente e produce artefatti più piccoli, rendendo pratico il deployment privato su hardware modesto.