Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dati AI, pipeline RAG, PDF a Markdown, LLM locali
Proteggi i dati proprietari della tua azienda con un'IA 100% privata, finetunata localmente.
Inviare documenti sensibili, materiali istruttivi o conoscenze interne alle API del cloud pubblico rappresenta un grande rischio per la sicurezza e spesso viola le normative GDPR.
Costruisco modelli di IA sicuri, offline, su misura per il tuo settore specifico. Utilizzando architetture Apple Silicon di alta gamma (128 GB di memoria unificata) e framework avanzati come MLX e Unsloth, i tuoi dati non lasciano mai il mio hardware isolato durante il processo di training.
Cosa consegno:
Il mio stack tecnologico & competenze:
Contattami prima di effettuare un ordine


Linguaggio di programmazione:
Python
Framework e strumenti per modelli IA:
Tipo di dati:
Testo
Motore IA:
Altro
Traduzione automatica.
Perché dovrei fare il finetuning localmente invece di usare OpenAI o altre API cloud?
Le API cloud rappresentano un grande rischio per la sicurezza dei dati proprietari e spesso violano le politiche GDPR più rigide. Il finetuning locale garantisce che i tuoi documenti sensibili, i dati dei clienti e le conoscenze interne non escano mai da un ambiente isolato e offline. Mantieni il controllo totale sui tuoi dati.
Sei in grado di finetunare modelli più grandi su hardware locale?
Sì. Utilizzo un'architettura Apple Silicon di alta gamma con 128 GB di memoria unificata. Combinato con framework di quantizzazione avanzati come MLX e Unsloth (QLoRA), questa enorme banda di memoria mi permette di finetunare ed eseguire modelli open-source di grandi dimensioni (come Llama, Mistral o Qwen) in modo efficiente.
In quale formato devono essere i miei dati di training?
Per il pacchetto Standard, i tuoi dati devono essere preparati come un file JSONL pulito contenente coppie istruzione-risposta strutturate. Se le tue conoscenze sono attualmente in PDF disordinati, testo grezzo o documenti interni, il mio pacchetto Premium include preprocessing Python personalizzato per estrarre, pulire e formattare i dati.
Quali file riceverò al momento della consegna?
Riceverai i pesi dell'adattatore LoRA finetunato insieme a un file modello completamente unito e quantizzato (formato GGUF). Questo file GGUF è pronto per il deployment e può essere trascinato e rilasciato immediatamente in motori di inferenza locali come Ollama, LM Studio o AnythingLLM sul tuo hardware aziendale.
Come garantisci che il modello impari davvero il mio dominio e non si limiti a overfittare?
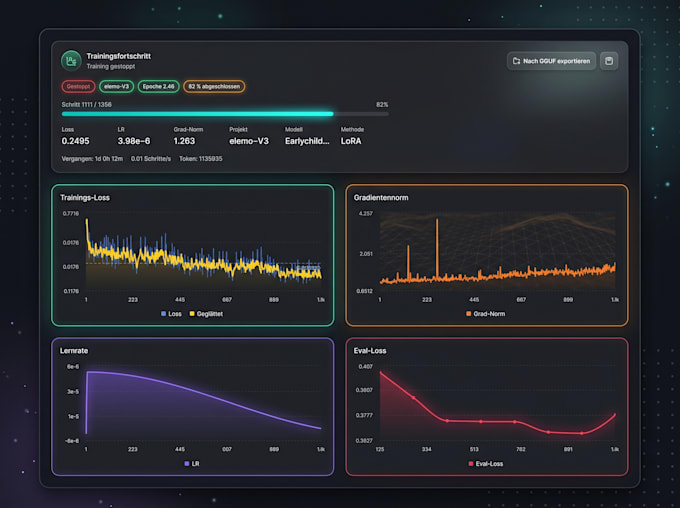
Monitoro rigorosamente le curve di perdita durante il training e aggiusto gli iperparametri per assicurarmi che il modello generalizzi bene alla tua terminologia specifica.