Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
passando alla bioinformatica
Stai cercando una pipeline automatizzata affidabile e ad alta velocità per elaborare sequenze biologiche FASTA senza lavoro manuale?
Sono specializzato nella creazione di pipeline modulari e riproducibili in Bash e Python, pensate per l'estrazione di sequenze FASTA da NCBI e l'analisi bioinformatica a valle.
### Cosa offro in questo servizio:
- Recupero automatico di sequenze NCBI: download batch di sequenze FASTA usando gli ID di accesso.
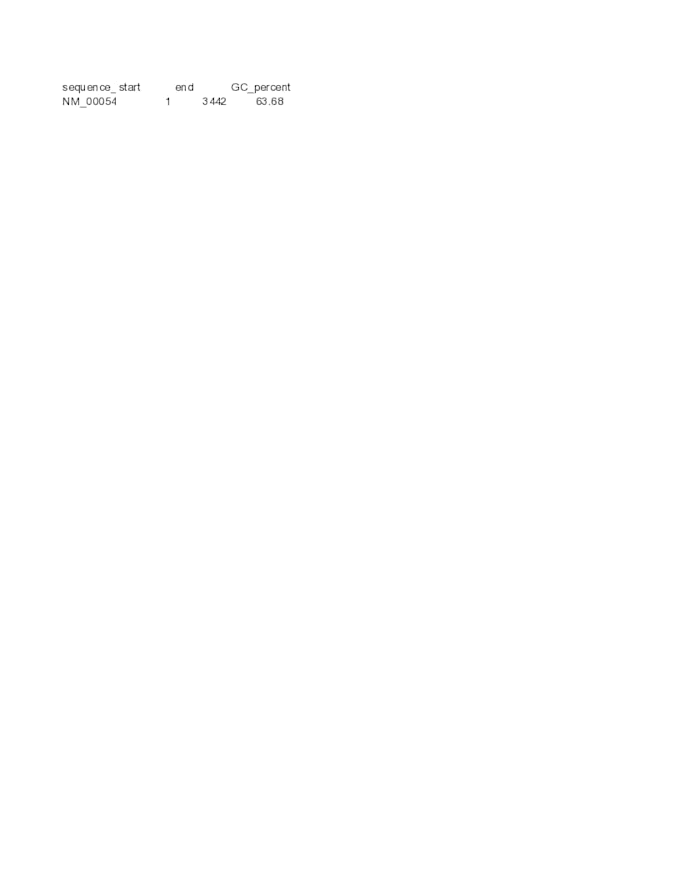
- Statistiche e metriche delle sequenze: calcolo della lunghezza totale, percentuali di GC/AT e statistiche N50.
- Profilazione GC a finestra: analisi dettagliata del contenuto di GC su finestre scorrevoli.
- Manipolazione delle sequenze: generazione automatica di reverse complement e pulizia degli header FASTA.
- Esportazione di dati strutturati: report TSV/CSV puliti per analisi a valle.
### Perché scegliere il mio servizio?
- Codice pulito e ben documentato: script modulari in Bash e Python progettati per una facile riutilizzabilità.
- Workflow ottimizzati per lo storage: esecuzione efficiente da riga di comando su ambienti Linux.
- Consegna rapida e supporto completo: istruzioni dettagliate per un'esecuzione senza problemi sul tuo terminale.
Sentiti libero di inviarmi un messaggio con le tue esigenze specifiche prima di effettuare un ordine!