Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Data Engineer esperto! Specialista in Data Pipeline! Migrazione di dati
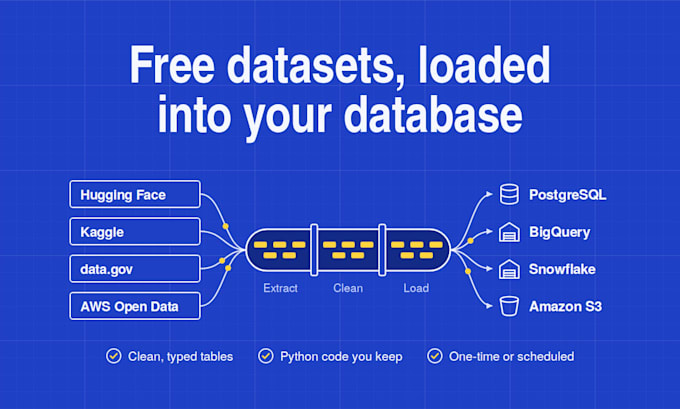
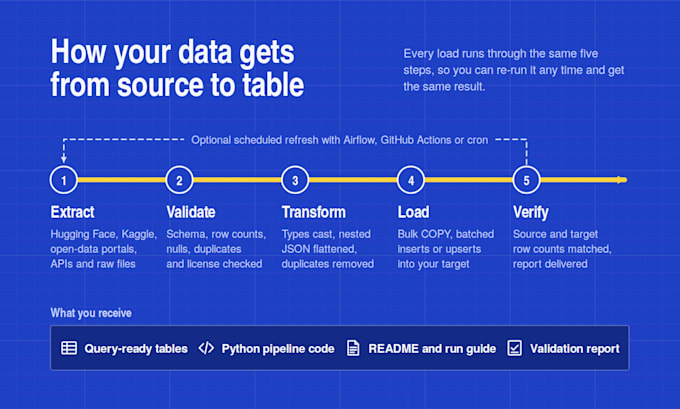
Hai bisogno di un dataset pubblico all’interno del tuo database? Lo prenderò da Hugging Face, Kaggle o qualsiasi fonte open-data, lo pulirò e lo caricherò nel tuo database, data warehouse o cloud storage, pronto per essere interrogato.
Quello che faccio:
Estrazione da Hugging Face, Kaggle, data.gov, AWS Open Data, BigQuery public datasets, API e file CSV, JSON o Parquet
Pulizia e trasformazione: correzione dei tipi di dato, appiattimento di JSON annidati, rimozione di duplicati e righe corrotte
Caricamento in PostgreSQL, MySQL, SQL Server, MongoDB, Supabase, BigQuery, Snowflake, Redshift, Databricks, S3, GCS o Azure
Streaming di grandi dataset in batch, così la dimensione è raramente un problema
Caricamenti incrementali e aggiornamenti programmati con Airflow, GitHub Actions o cron
Dataset di testo incorporati e caricati in pgvector, Pinecone o Qdrant per AI e RAG
Ottieni:
- Tabelle pronte per le query nel tuo storage
- Codice Python pulito e riutilizzabile
- Un README e un report di validazione (conteggio righe, schema)
Controllo ogni licenza del dataset e segnalo eventuali restrizioni prima di caricarlo.
Non sei sicuro di quale package sia adatto? Inviami il link del dataset e la destinazione prima di ordinare, e ti consiglierò quale scegliere.