Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Automazione AI e sviluppatore full stack
Hai bisogno di un modello di machine-learning che trasformi i tuoi dati in previsioni utili?
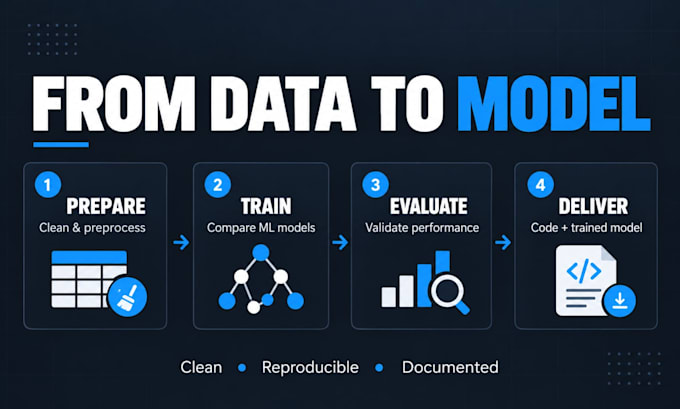
Costruirò un modello di classificazione o regressione personalizzato usando il tuo dataset strutturato/tabellare e fornirò una valutazione chiara, codice Python riproducibile e risultati documentati.
Posso aiutarti con:
Contattami prima di ordinare se il tuo dataset richiede una pulizia approfondita, più fonti di dati, deep learning, NLP, previsione di serie temporali, deployment su cloud o elaborazione su larga scala.
I risultati dipendono dal tuo dataset e dall'impostazione di valutazione, quindi non posso garantire specifiche precisioni o risultati aziendali.


Linguaggio di programmazione:
Python
•
R
•
MATLAB
•
SQL
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Altro
Strumenti:
Quaderno jupyter
•
opencv
•
OpenNN
•
tensorflow
•
Excel
•
Colab
Traduzione automatica.
Su quali tipi di problemi di machine-learning puoi lavorare?
Questo servizio si concentra su problemi di machine-learning supervisionato usando dati strutturati/tabellari, principalmente classificazione e regressione. Contattami prima per previsioni di serie temporali, NLP, computer vision, deep learning o tipi di dati insoliti.
Cos'è la classificazione?
La classificazione prevede di assegnare una categoria o classe, come churn/non churn, frode/non frode, approvato/rifiutato, o una categoria tra diverse possibili.
Cos'è la regressione?
La regressione prevede di stimare un valore numerico, come prezzo, livello di domanda, punteggio, ricavi o un altro target continuo.
Quali dati devo fornire?
Fornisci un dataset strutturato come CSV, Excel o altro formato tabellare concordato, insieme a una descrizione delle colonne e del target che vuoi prevedere.
Puoi pulire il mio dataset?
La pulizia è inclusa nei limiti del pacchetto. Pulizie approfondite, fusione di molte fonti di dati, etichettatura manuale o ricostruzione di dataset molto incompleti potrebbero richiedere un'offerta personalizzata.
Quali algoritmi di machine-learning utilizzerai?
L'algoritmo dipende dal tuo dataset e dal compito di previsione. Approcci adatti possono includere modelli di regressione, alberi decisionali, Random Forest, gradient boosting, XGBoost e altri metodi classici di machine-learning appropriati.
Puoi garantire una precisione specifica?
No. La performance del modello dipende fortemente dalla qualità, quantità, rilevanza, equilibrio e prevedibilità dei dati forniti. Utilizzerò metodi di valutazione appropriati e riporterò chiaramente i risultati ottenuti.
Riceverò il codice sorgente?
Sì. Riceverai il codice Python riproducibile o il notebook incluso nel tuo pacchetto, insieme agli artefatti del modello e alla documentazione rilevante.
Puoi implementare il modello?
Il pacchetto Premium include prototipo API di inferenza o script di previsione batch. Deployment completo su cloud, monitoraggio, infrastruttura scalabile e MLOps continuo sono servizi separati.