Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Descrizione del servizio
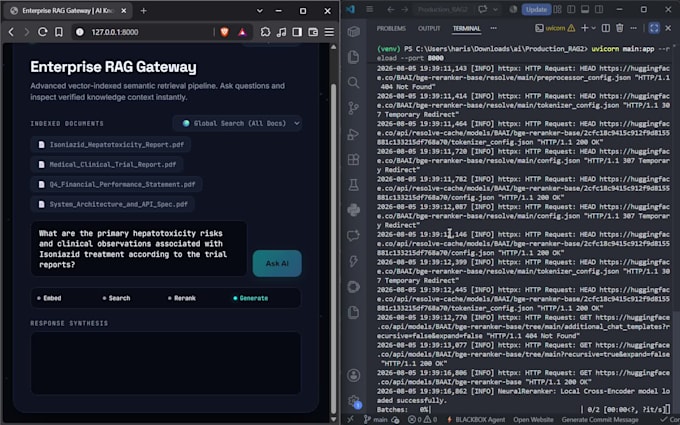
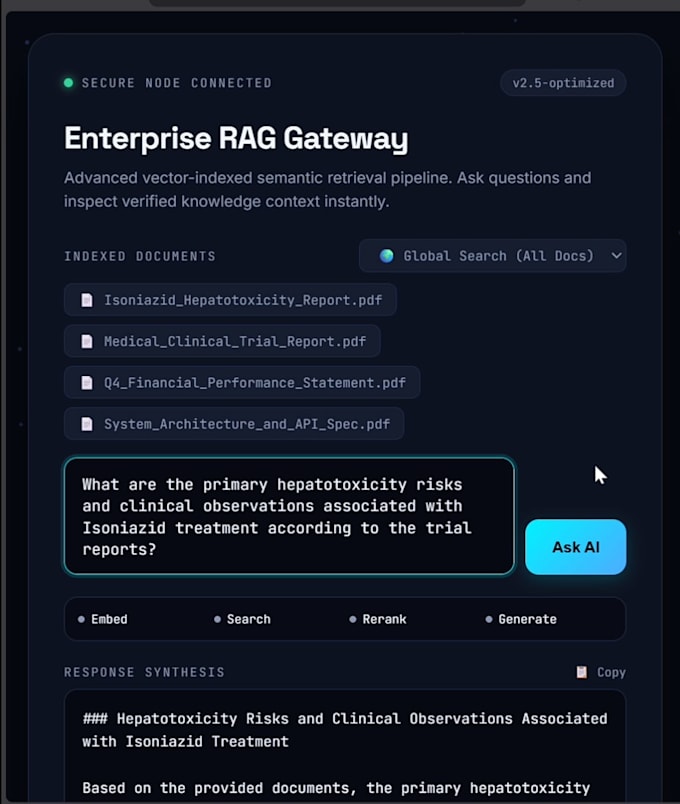
Vuoi un'AI che possa conversare con i tuoi PDF, documenti o database in modo preciso? Costruirò un sistema RAG pronto per la produzione per la tua attività...
Sono specializzato in architetture GenAI per la produzione e sistemi backend asincroni usando Python, FastAPI, Vector DBs e LLMs (OpenAI, Groq, Llama 3).
️ Capacità principali:
Piattaforma tecnologica:
Python | FastAPI | Qdrant | Pinecone | LlamaIndex | LangChain | OpenAI | Groq | Docker
Perché scegliermi?
Parliamo del tuo progetto! Scrivimi prima di ordinare così possiamo personalizzare l'architettura in base alle tue esigenze specifiche di dati.
Enterprise Rag and AI Systems Engineer
Lingue
Traduzione automatica.
Traduzione automatica.
Q1: Quali prerequisiti devo fornire prima di iniziare?
Risposta: Devi condividere le specifiche del progetto, dati/documenti di esempio e le API keys per i provider LLM o Vector DB scelti (ad esempio OpenAI, Groq, Pinecone). Se non hai ancora le chiavi, posso guidarti su come configurarle in modo sicuro in un file .env.
Q2: I miei dati e le API keys resteranno sicuri durante lo sviluppo?
Risposta: Sì, assolutamente. I tuoi dati, la logica di business e le credenziali rimangono completamente confidenziali. Tutte le credenziali sensibili sono caricate tramite variabili di ambiente (.env) e mai hardcodate o condivise.
Q3: Puoi gestire il parsing personalizzato di documenti come tabelle complesse e PDF?
Risposta: Sì. Utilizzo strumenti di parsing consapevoli del layout (come LlamaParse) e strategie di chunking personalizzate per estrarre e strutturare tabelle, PDF, Markdown e documenti di testo prima di indicizzarli nel vector database.
Q4: L'applicazione è pronta per il deployment cloud?
Risposta: Sì. Ogni consegna include codice Python strutturato, endpoint FastAPI, un modello .env.example e un Dockerfile ottimizzato, così puoi deployare subito su AWS, GCP, Azure o qualsiasi server locale.
Q5: Cosa succede se un provider LLM va offline o raggiunge i rate limit?
Risposta: Costruisco resilienza integrata usando algoritmi di retry e routing multi-provider con failover (ad esempio passare automaticamente da Groq a OpenAI se si raggiungono i rate limit) per garantire alta disponibilità.