Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Stai cercando di integrare dati personalizzati nei Large Language Models (LLMs) con alta precisione e bassa latenza?
Costruisco sistemi Retrieval-Augmented Generation (RAG) robusti, pronti per la produzione, e flussi di lavoro AI agentic su misura per le tue esigenze di business.
Cosa offro:
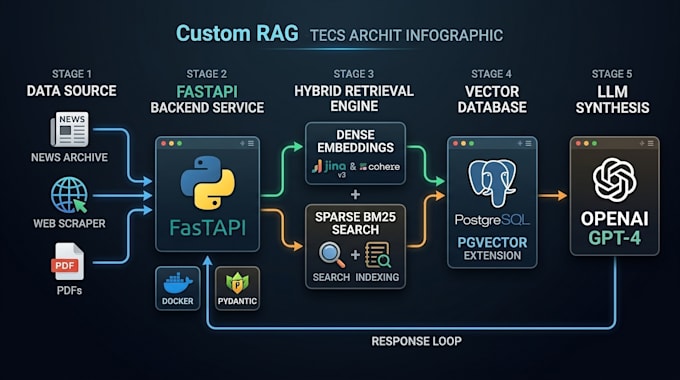
- Architettura RAG personalizzata: suddivisione dei documenti, generazione di embedding (Cohere, OpenAI, Jina) e archiviazione dei vettori.
- Database di vettori: integrazione con PostgreSQL (pgvector), Pinecone o Qdrant.
- Ricerca ibrida: ricerca dense + sparse per la massima precisione di recupero.
- Integrazione backend: API REST ad alte prestazioni costruite con Python e FastAPI.
- Agenti AI autonomi: flussi di lavoro LangGraph per compiti complessi e multi-step.
- Codice pulito e documentazione: codice completamente tipizzato (Pydantic), documentato e Dockerizzato.
Piattaforma tecnologica:
Python | FastAPI | PostgreSQL / pgvector | LangChain / LangGraph | Docker | OpenAI / Cohere
Come lavoriamo:
1. Contattami con le tue esigenze prima di effettuare un ordine.
2. Definiamo insieme l'ambito del progetto, la tecnologia e i deliverables.
3. Costruisco, testo e consegno il sistema con istruzioni passo passo.
Trasforma i tuoi dati in un sistema AI intelligente. Scrivimi un messaggio per iniziare!
Software Engineer
Lingue
Traduzione automatica.
Traduzione automatica.
Puoi deployare il sistema RAG sul mio server?
Sì, fornisco configurazioni Dockerizzate e guide di deployment per piattaforme cloud come AWS, DigitalOcean o Hetzner.
Devo avere le mie API keys?
Sì, avrai bisogno delle tue API keys per i servizi LLM (ad esempio OpenAI, Cohere, Anthropic). Posso guidarti nella configurazione.
