Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
La bolla del freelance
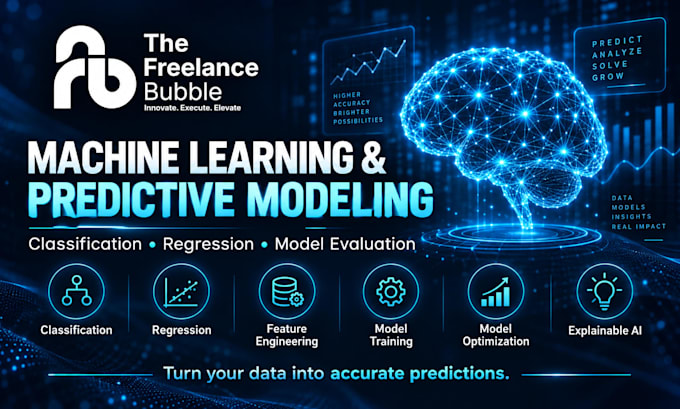
Costruirò modelli di machine learning e predittivi accurati, interpretabili e documentati professionalmente, su misura per i tuoi dati e obiettivi di progetto.
Posso lavorare con dataset di ricerca, sanità, business, scientifici e strutturati per trasformare dati grezzi in previsioni significative e insight utili.
I miei servizi includono:
Lavoro con Python, R, Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter, Colab e RStudio.
Contattami prima di ordinare per deep learning, dataset molto grandi, deployment su cloud, integrazione API o workflow personalizzati.
Traduzione automatica.
Quali tipi di progetti di machine learning puoi gestire?
Posso lavorare su classificazione, regressione, clustering, rilevamento di anomalie, analisi predittiva, feature engineering, modelli decision tree e valutazione dei modelli per dataset di ricerca, sanità, business e scientifici.
Cosa devo fornirti prima di iniziare?
Fornisci il tuo dataset, obiettivo del progetto, variabile target se applicabile, output preferito e eventuali requisiti o domande specifiche che vuoi che il modello affronti.
Quali linguaggi e strumenti di programmazione utilizzi?
Utilizzo principalmente Python e R con Scikit-learn, TensorFlow, PyTorch, XGBoost, Jupyter Notebook, Colab, RStudio, SQL e altri strumenti di data science.
Fornirai il codice sorgente?
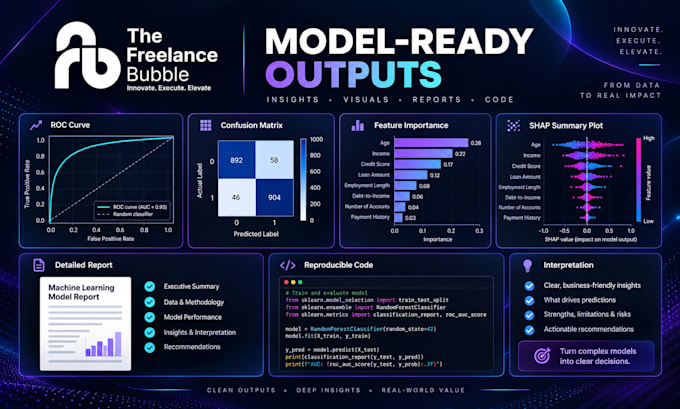
Sì. Il codice sorgente o i notebook sono inclusi in base al pacchetto scelto e saranno organizzati per la riproducibilità e revisione.
Puoi confrontare più modelli di machine learning?
Sì. I pacchetti Standard e Premium possono includere più modelli, cross-validation, confronto tra modelli, ottimizzazione e selezione basata su metriche di performance appropriate.
Fornisci AI spiegabile o analisi SHAP?
Sì. AI spiegabile, valori SHAP, importanza delle feature e interpretazione possono essere incluse, in particolare nel pacchetto Premium o tramite un'offerta personalizzata.
Puoi lavorare con dati di sanità o ricerca?
Sì. Posso analizzare dataset biomedici, sanitari, di ricerca e scientifici. Assicurati che eventuali dati sensibili siano correttamente anonimizzati prima di condividere.
Offri deployment del modello o integrazione API?
Sì, il deployment su cloud e l'integrazione API possono essere aggiunti come extra o gestiti tramite un'offerta personalizzata a seconda della complessità del progetto.
Puoi garantire una precisione specifica del modello?
No. La performance del modello dipende dalla qualità dei dati, dalla dimensione del campione, dall'equilibrio delle classi, dalla rilevanza delle feature e dal problema di previsione sottostante. Mi concentro su validazioni rigorose e report trasparenti, non su garanzie irrealistiche.
Devo contattarti prima di ordinare?
Sì, soprattutto per dataset grandi, deep learning, progetti di sanità, deployment, API o requisiti di machine learning personalizzati.