Esegui modelli LLaMA localmente sul tuo hardware e sblocca un AI veloce e privato! Sono specializzato nel deployment di LLaMA LLMs per principianti e sviluppatori usando llama.cpp, un motore di inferenza leggero in C/C++ che permette inferenza locale ad alte prestazioni. Otterrai una configurazione completa su Windows e Linux. niente cloud, nessuna tariffa ricorrente e pieno controllo sui tuoi modelli di AI.
- Installazione locale: Installerò e configurerò gli ultimi modelli LLaMA (2/3) o compatibili GGUF sul tuo computer. Che tu usi Windows, Linux o Mac, gestisco configurazione dell'ambiente, dipendenze e build o installazione binaria di llama.cpp
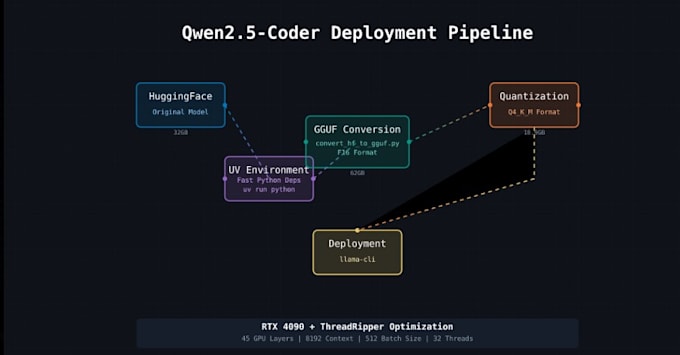
- Ottimizzazione GPU & CUDA: Con supporto NVIDIA CUDA, abiliterò l'accelerazione GPU (e multi-threading) per accelerare l'inferenza. Usando le ottimizzazioni di llama.cpp e la quantizzazione del modello (4-bit/8-bit), ridurremo l'uso della memoria così anche modelli grandi funzionano senza problemi (I modelli quantizzati sono molto più leggeri mantenendo una buona precisione)
- Fine-tuning & dati personalizzati: Nel pacchetto Premium, effettuo il fine-tuning del tuo modello LLaMA sul tuo dataset usando LoRA adapters (LoRA ci permette di adattare il modello alle tue esigenze allenando solo i pesi dell'adapter)