Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD


Traduzione automatica.
Ciao! Sono uno sviluppatore full-stack specializzato in chatbot AI e integrazione di LLM, con oltre 3 anni di esperienza.
Ho creato la mia piattaforma di machine learning (njmaet) e distribuito modelli MoE da 35B di parametri su server con 8-GPU per clienti aziendali. Conosco i sistemi di AI dall'inizio alla fine: dalla scelta del modello alla distribuzione in produzione.
COSA COSTRUISCO PER TE:
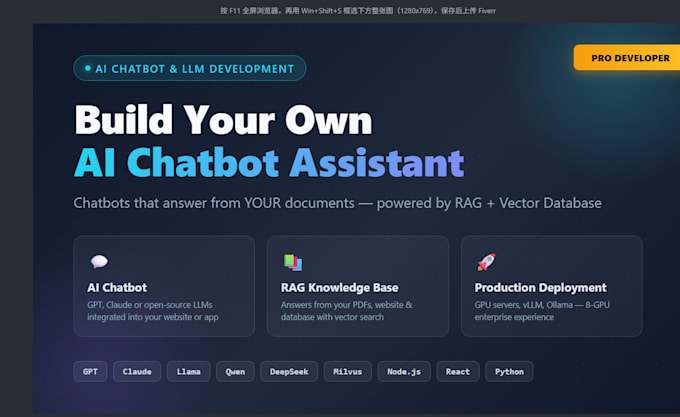
1. chatbot AI GPT, Claude o modelli open-source (Llama, Qwen, DeepSeek) integrati nel tuo sito o app
2. chatbot RAG un chatbot che risponde dai TUOI documenti (PDF, sito web, database) usando la ricerca vettoriale (Milvus, Faiss)
3. assistenti AI personalizzati perfezionati sui tuoi dati, parlando con la voce del tuo brand
PERCHÉ LAVORARE CON ME:
- Esperienza reale in produzione: distribuisco LLM (7B-70B) su server GPU usando vLLM e Ollama
- Full-stack: il tuo chatbot avrà un'interfaccia web pulita (Node.js + React), non solo uno script
- Gestisco API, database, distribuzione e documentazione
- Comunicazione chiara, consegna puntuale
1. Mandami un messaggio descrivendo il tuo progetto
2. Rispondo con un piano, una timeline e il pacchetto più adatto a te
3. Ricevi aggiornamenti sul progresso fino alla consegna
Hai domande? Messaggia
Full Stack Developer and AI LLM Deployment Specialist
Lingue
Traduzione automatica.
Traduzione automatica.
Cosa ti serve da me per iniziare?
Basta una descrizione del tuo progetto: cosa dovrebbe fare il chatbot, dove verrà usato (sito, app), e eventuali documenti o dati da cui deve rispondere. Ti guiderò nel resto.
Il chatbot può rispondere a domande sui miei documenti?
Sì! È proprio quello che fa RAG. Collego i tuoi PDF, contenuti del sito o database al chatbot, così risponde dai TUOI dati con risposte accurate e pertinenti.
Usi OpenAI GPT o modelli open-source?
Entrambi. Posso usare OpenAI GPT o Claude, oppure modelli open-source (Llama, Qwen, DeepSeek) se vuoi evitare costi API o distribuire privatamente sul tuo server.
Devo avere la mia API key o server?
Per chatbot basati su GPT, ti serve una API key di OpenAI (ti mostrerò come). Per modelli open-source, posso distribuire sul tuo server o consigliarti l'hosting più economico.
Offrite supporto dopo la consegna?
Sì — il pacchetto Premium include documentazione e un periodo di supporto. Piccole correzioni sono sempre gratuite. Per manutenzione a lungo termine, contattami per un'offerta personalizzata.
