Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dei dati
Hai query lente in BigQuery, modelli dbt rotti o job Spark non ottimizzati?
Sono un Senior Data Engineer (Databricks Associate Certified) con oltre 5 anni di esperienza nella creazione e ottimizzazione di architetture di dati scalabili nel cloud (GCP, Databricks, BigQuery). Mi specializzo nel trasformare pipeline di dati complesse, lente e costose in flussi di lavoro veloci, efficienti e convenienti.
Ecco cosa posso fare per te:
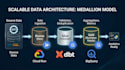
- dbt & Data Warehousing: Costruire e rifattorizzare modelli dbt seguendo l'Architettura Medallion (Bronze, Silver, Gold), ottimizzare le query SQL e configurare esecuzioni Cloud Run / Control-M / Airflow.
- PySpark & Databricks: Debuggare, rifattorizzare e velocizzare pipeline batch ETL con Spark (Scala/Python).
- Architettura Cloud GCP: Configurare pipeline scalabili con BigQuery, Cloud Run e Airflow/Composer.
- Ottimizzazione di database e query: Ridurre i costi di elaborazione e i tempi di esecuzione di BigQuery/Snowflake.
Perché lavorare con me?
- Certificazioni: Data Engineer Certificato da Databricks & Certificato Azure.
- Codice di alta qualità: Pratiche di ingegneria dei dati pulite, modulari e manutenibili.
- Comunicazione chiara e diretta: disponibile in inglese e spagnolo.
NOTA: Contattami con le tue esigenze prima di ordinare

Strumenti e piattaforme:
Google Cloud Dataflow
•
Apache NiFi
•
Altro
Traduzione automatica.
Accetti ordini personalizzati a lungo termine?
Sì, ma solo per micro-task specifici o consulenze part-time. Per favore, inviami un messaggio prima per discutere i dettagli.
Cosa devo fornire prima di iniziare?
Accesso all'ambiente cloud (o dati/codice di esempio anonimizzato) e una descrizione chiara dell'output atteso o dei log di errore.
Possiamo programmare una chiamata per discutere del progetto?
Sì, tramite la funzione di videochiamata di Fiverr una volta avviato un ordine o richiesta.


