Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Specialista in Machine Learning, NLP
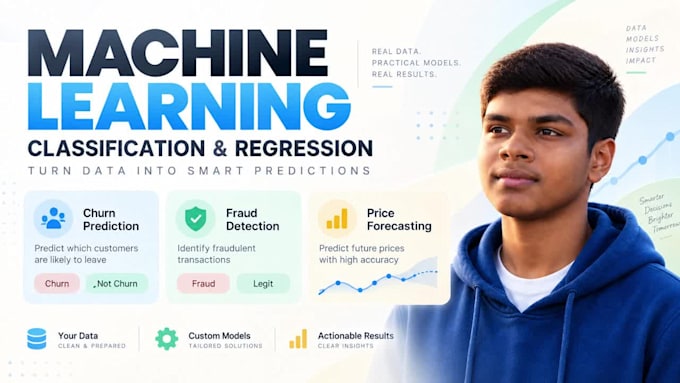
Hai bisogno di un modello di machine learning affidabile per classificazione, regressione o previsione?
Portfolio: https://kawsar-portfolio-kawsar07ahmmed0712-5454.vercel.app/
Creo soluzioni di machine learning pulite e pratiche per dati strutturati e tabellari usando Python.
In cosa posso aiutarti:
Strumenti che uso:
Scikit-learn, XGBoost, LightGBM, CatBoost, Pandas, NumPy, Jupyter Notebook e TensorFlow quando necessario.
Riceverai codice sorgente pulito, un modello addestrato, risultati di valutazione, visualizzazioni e documentazione chiara. I pacchetti Standard e Premium includono tuning più approfonditi e confronto tra modelli, mentre il Premium può anche includere integrazione API Flask.
Per favore, inviami un messaggio con il tuo dataset e l'obiettivo del progetto prima di ordinare, così posso consigliarti il pacchetto più adatto.
Grazie,
Kawsar Ahmmed




Linguaggio di programmazione:
Python
•
SQL
•
Colab
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Altro
Strumenti:
Quaderno jupyter
•
tensorflow
•
Excel
•
Colab
Traduzione automatica.
Con che tipi di dataset puoi lavorare?
Lavoro principalmente con dataset strutturati o tabellari come file CSV ed Excel contenenti feature numeriche o categoriche. Se non sei sicuro che il tuo dataset sia adatto, per favore inviami un messaggio prima di ordinare.
Devo sapere se il mio problema è di classificazione o regressione?
No. Spiega semplicemente cosa vuoi prevedere, e io analizzerò la tua variabile target e ti consiglierò l'approccio di machine learning più adatto.
Come scegli il modello di machine learning più adatto ai miei dati?
Confronto gli algoritmi più adatti in base al tuo dataset, al tipo di problema e alle metriche di valutazione. A seconda del progetto, posso usare modelli come regressione logistica o lineare, Random Forest, XGBoost, LightGBM, CatBoost, SVM o KNN.
Cosa riceverò con il mio ordine?
A seconda del pacchetto, riceverai codice sorgente Python pulito, un Jupyter Notebook, workflow di preprocessing, modello addestrato, risultati di valutazione, visualizzazioni rilevanti e documentazione del modello.
Puoi lavorare con dataset disordinati o sbilanciati?
Sì. Posso gestire problemi comuni come valori mancanti, feature categoriche, scaling, feature engineering e sbilanciamento delle classi usando tecniche di preprocessing appropriate.
Puoi garantire un punteggio di accuratezza o performance specifico?
Non posso garantire un'accuratezza fissa perché la performance del modello dipende dalla qualità, dimensione, equilibrio e informazioni predittive del dataset. Utilizzerò metodi di validazione, metriche e ottimizzazione appropriati per ottenere un risultato affidabile.
Fornisci integrazione API per il modello addestrato?
Sì. Il pacchetto Premium può includere integrazione API Flask in modo che il modello addestrato possa accettare input e restituire previsioni tramite API. La distribuzione su cloud non è inclusa a meno di accordi separati.