Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere di computer vision, YOLO e deployment in tempo reale
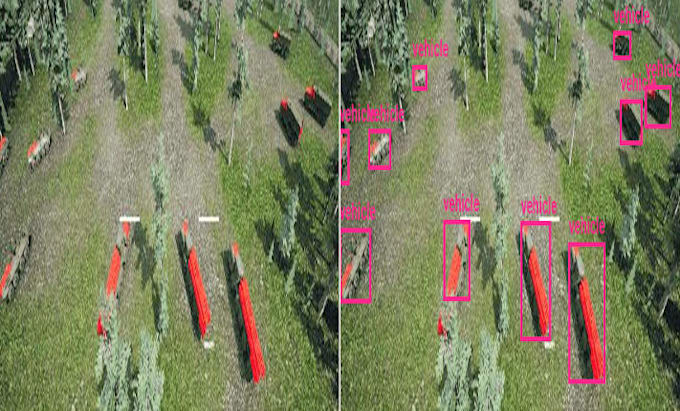
Annotazione precisa di bounding box e poligoni per dati di addestramento di computer vision, consegnati nel formato che la tua pipeline si aspetta.
Sono un ingegnere di computer vision, non un contractor di etichettatura. Questo si vede nelle situazioni limite: oggetti occlusi, confini di classe ambigui e istanze vicino al limite di risoluzione. Etichetto nel modo in cui un modello deve essere insegnato, e segnalo le decisioni che dovresti prendere invece di indovinare silenziosamente per te.
COSA RICEVI
Bounding box o maschere di segmentazione poligonale
Esportazione in YOLO, COCO JSON o Pascal VOC XML
Sommario della distribuzione delle classi per vedere squilibri prima dell'addestramento
Note sui casi ambigui e come li ho risolti
Standard e Premium includono una revisione QA del secondo passaggio di ogni annotazione.
Premium include una divisione train val test sicura da leakage, raggruppata in modo che frame quasi duplicati non possano finire su entrambi i lati e gonfiare il punteggio di validazione.
L'estrazione dei frame video è inclusa senza costi aggiuntivi. Inviami il footage grezzo e il tuo tasso di campionamento.
Scrivimi con il numero di immagini e la lista delle classi per un preventivo preciso.

Tecnica:
Manuale
Tipo di tag:
Immagine
•
Video
Traduzione automatica.
Come fai a mantenere la coerenza dell'etichettatura su migliaia di immagini?
Scrivo una breve linea guida di etichettatura prima di iniziare, che copre cosa conta come istanza, come gestire l'occlusione e la dimensione minima dell'oggetto, e te la mando per approvazione. La coerenza deriva dal decidere le regole una volta, all'inizio, non caso per caso.
Puoi annotare anche video?
Sì. Inviami il footage grezzo e il tuo tasso di campionamento e io estraggo i frame senza costi aggiuntivi. I frame di uno stesso clip sono quasi duplicati, quindi li raggruppo quando divido per mantenere fuori sia dal train che dalla validazione.
I miei dati vengono mantenuti riservati?
Sì. I tuoi dati vengono usati solo per il tuo progetto, conservati localmente durante il lavoro e cancellati su richiesta dopo la consegna. Sono felice di firmare un NDA prima che tu invii qualsiasi cosa.
Cosa succede se non sono d'accordo con alcune etichette?
Inviami i file specifici e cosa avresti fatto diversamente. Rivedo quelli e aggiorno la linea guida in modo che la stessa decisione venga mantenuta nel resto del set. Le revisioni sono incluse in ogni pacchetto.