Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Traduzione automatica.
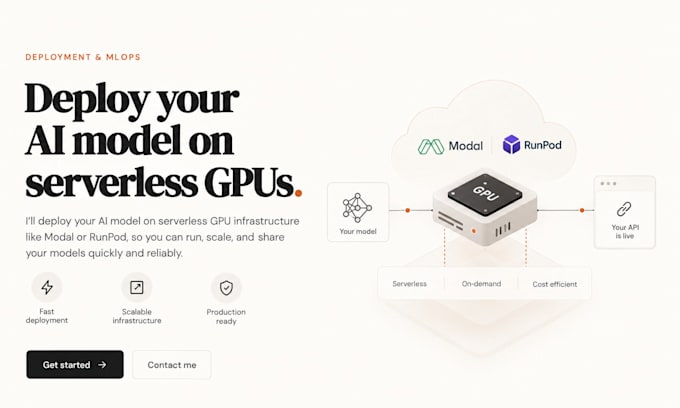
Costruisco e ottimizzo backend di inferenza AI per app che hanno bisogno di una vera GPU, non solo di un wrapper intorno all'API di ChatGPT.
Ho distribuito e ottimizzato pipeline AI in produzione (elaborazione di immagini/video, modelli generativi stile face-swap) sulla infrastruttura GPU serverless di Modal, tra cui:
- Configurazione di istanze GPU/CPU (L4/T4) ottimizzata per costi e latenza
- Ottimizzazione di cold-start e warmup per ridurre i secondi di GPU sprecati
- Snapshot della memoria GPU per ridurre i tempi di cold-start
- Ottimizzazione della pipeline ~75% di riduzione del tempo di elaborazione su un carico di lavoro in produzione
- Gestione dei segnali e correzioni di affidabilità per lavori di inferenza di lunga durata
Mobile App Developer
Lingue
Traduzione automatica.
