Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Ingegnere AI, Machine Learning, Deep Learning, NLP, Computer Vision, Agentic AI
Hai problemi con dati disordinati per il tuo progetto ML?
Farò Data Cleaning, Data Scraping, Data Preprocessing e Data Visualization professionali in Python.
Non perdere tempo con dati sporchi. renderò il tuo dataset al 100% pronto per ML.
SERVIZI INCLUSI:
Data Cleaning - rimuovere null, duplicati, outlier, formati sbagliati
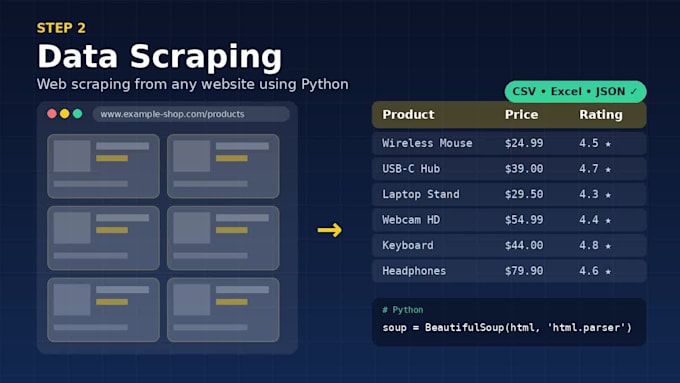
Data Scraping - estrazione dati da qualunque sito web usando Python
Data Preprocessing - codifica, scaling, normalizzazione per modelli ML
Data Visualization - EDA con Matplotlib, Seaborn, Plotly
Strumenti: Python, Pandas, NumPy, Scikit-learn, BeautifulSoup, Selenium
COSA OTTIENI:
- CSV/Excel puliti + Jupyter Notebook con codice Python
- Report EDA con 5-10 grafici belli
- Dataset ML-Ready (train/test split)
- Consulenza live per spiegare tutto
Ho esperienza in Spam Detection, Brain Tumor Detection e progetti NLP. I tuoi dati sono al sicuro con me.
Contattami PRIMA dell'ordine per discutere del tuo dataset!
Parole chiave: data cleaning, data scraping, data preprocessing, data visualization, Pandas, python, EDA, machine learning
Traduzione automatica.
Di quali file hai bisogno per iniziare?
Mi serve il tuo dataset (CSV, Excel, Google Sheet) e una breve descrizione di cosa vuoi. Se serve scraping, inviami solo il link del sito. Contattami prima di ordinare!
Puoi fare web scraping da qualsiasi sito?
Sì, posso raspeare dati dalla maggior parte dei siti usando Python (BeautifulSoup, Selenium). Ti darò i dati in formato CSV/Excel pulito + codice Python per lo scraping. Alcuni siti molto protetti potrebbero richiedere una discussione.
Cosa otterrò nella visualizzazione dei dati?
Otterrai EDA con 5-10 grafici professionali (Matplotlib, Seaborn, Plotly) - istogramma, heatmap di correlazione, boxplot, ecc. + rapporto di insight. Fornisco anche consigli su Power BI / Tableau nel Pacchetto Premium.
Il mio dataset sarà ML-ready?
Sì, al 100%. Mi occuperò di valori nulli, duplicati, outlier, codifica di dati categorici, scaling/normalizzazione e split train-test. Puoi usarlo direttamente per addestrare modelli ML in Python, Sklearn.