Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Ingegnere dei dati
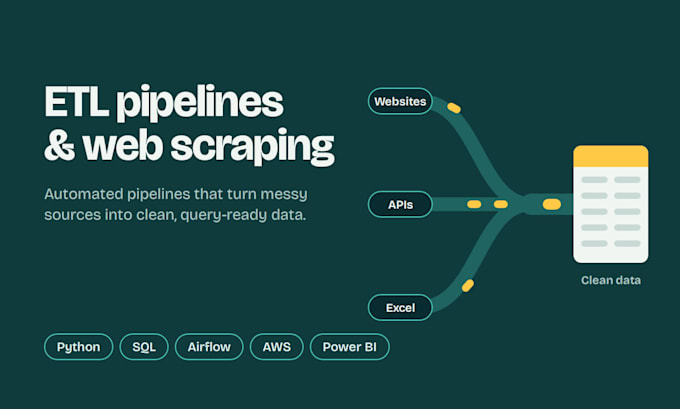
Hai bisogno di dati da siti web o hai dati ma nessun sistema affidabile per muoverli? Fogli di calcolo, API e database che non combaciano mai, report rifatti a mano ogni settimana, pipeline che si interrompono dall'oggi al domani? Io risolvo questo.
Sono un Data Engineer con 4 anni di esperienza e un MSc in Big Data Analytics dal Regno Unito. Attualmente costruisco pipeline di produzione per grandi marketplace online, includendo tabelle dei fatti incrementali in Redshift con oltre 20 milioni di record.
Cosa costruisco:
Perché scegliere me: esperienza reale in produzione, codice pulito documentato che tu possiedi, e aggiornamenti chiari ad ogni passo.
Scrivimi prima di ordinare così posso definire al meglio la tua esigenza.
Traduzione automatica.
Con quali strumenti lavori?
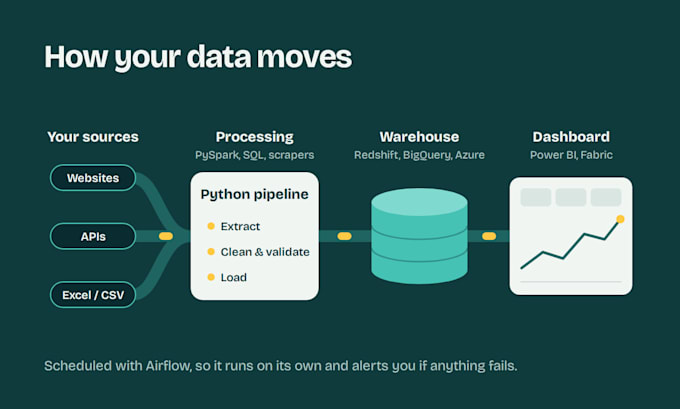
Python, SQL, PySpark, Apache Airflow, Matillion, Talend, AWS (Redshift, Lambda), Azure, Google BigQuery e Power BI, oltre a BeautifulSoup, Requests, Selenium, Scrapy e Playwright per web scraping.
Riesci a eseguire lo scraping di siti che caricano contenuti con JavaScript?
Sì. Per i siti dinamici uso strumenti di automazione del browser come Selenium o Playwright invece delle semplici richieste di pagina.
Puoi lavorare con il mio pipeline esistente?
Sì. Posso eseguire debugging, ottimizzare o estendere le pipeline che hai già, incluso sistemare record duplicati o mancanti.
In quale formato riceverò i miei dati?
CSV, Excel, JSON, Google Sheets, o caricati direttamente nel tuo database o data warehouse.
Possiedo il codice?
Sì. Ottieni l'intero codice sorgente, e Standard e Premium includono anche la documentazione.
Scrape qualsiasi sito web?
Io eseguo scraping solo su dati pubblici. Non eseguo scraping su social o contenuti dietro login senza permesso, poiché va contro le regole di Fiverr.
Riesci a costruire pipeline in tempo reale?
Le pipeline batch pianificate sono la mia offerta principale. Per esigenze in tempo reale, scrivimi prima e vediamo se è fattibile.