Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Data Scientist e AIML Engineer
Hai bisogno di un modello di machine learning che funzioni davvero sui tuoi dati, non solo in un notebook?
Sono un Data Scientist con un MSc in Data Science (UK) che costruisce, valuta e distribuisce modelli ML in Python. Mi concentro su risultati affidabili: dati puliti, test senza leakage e le metriche giuste per il tuo problema.
COSA POSSO COSTRUIRE PER TE
- Previsione del churn dei clienti
- Previsioni di vendite e domanda
- Modelli di classificazione e regressione
- Clustering e segmentazione clienti
- Rilevamento di anomalie
- App web o API in tempo reale per il tuo modello (Premium)
COSA OTTIENI
- Pulizia dei dati e analisi esplorativa
- Modello costruito con Scikit-learn, XGBoost o TensorFlow/Keras
- Rapporto chiaro sui risultati in italiano semplice
- Codice sorgente Python completo e notebook Jupyter
LAVORI RECENTI
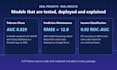
- Modello di churn per telecomunicazioni: 4 modelli confrontati, AUC 0.829, distribuito su AWS
- Manutenzione predittiva: motore di previsione di guasti con modello GRU, distribuito su Google Cloud
- Classificatore di reddito: accuratezza dell'87%, ROC-AUC 0.92
Contattami PRIMA di ordinare con una breve descrizione dei tuoi dati e obiettivo, così posso confermare il pacchetto giusto per te.

Linguaggio di programmazione:
Python
•
R
•
SQL
•
Colab
Framework:
Scikit-learn
•
keras
•
PyTorch
•
Panda
•
Altro
Strumenti:
Quaderno jupyter
•
tensorflow
•
Colab
•
RStudio
Traduzione automatica.
Cosa ti serve da me per iniziare?
Il tuo dataset (CSV, Excel o esportazione da database), una breve descrizione di cosa vuoi prevedere, e eventuali scadenze o preferenze sugli strumenti. Se i tuoi dati non sono ancora pronti, contattami e ti aiuterò a pianificare cosa raccogliere.
Quale pacchetto devo scegliere?
Base se hai bisogno di testare un modello su un dataset. Standard se vuoi il meglio di diversi modelli, ottimizzati e spiegati. Premium se vuoi che il modello funzioni come app live o API che il tuo team può usare.
Puoi garantire una precisione specifica?
Nessun data scientist onesto può garantire l'accuratezza prima di aver visto i dati, perché dipende dalla qualità dei dati e da quanto il problema è prevedibile. Ti dirò presto quali risultati sono realistici e riporterò sempre i risultati su dati di test non visti, non su score di training gonfiati.
Riceverò il codice sorgente?
Sì. Ogni pacchetto include il codice sorgente Python completo e un notebook Jupyter, così possiedi tutto e puoi ri-eseguire o estendere il modello.
I miei dati vengono mantenuti riservati?
Sì. Uso i tuoi dati solo per il tuo progetto, non li condivido mai e li elimino dopo la consegna se lo chiedi. Sono disponibile a firmare un NDA.


