Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Esperto senior in Data Engineering e Analytics
Hai bisogno di una pipeline ETL/ELT scalabile o di una soluzione Medallion Lakehouse in Azure Databricks?
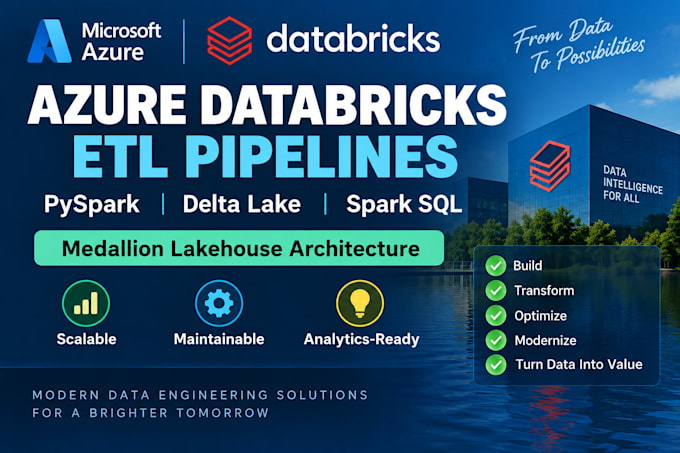
Costruirò e ottimizzerò pipeline di dati Azure Databricks usando PySpark, Spark SQL, Delta Lake e pratiche moderne di data-engineering.
Posso aiutarti con:
pipeline ETL/ELT Azure Databricks
trasformazioni PySpark e Spark SQL
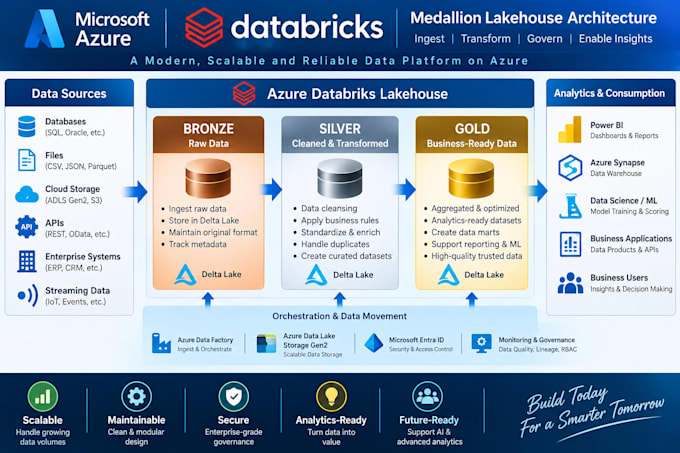
architettura Bronze, Silver e Gold Medallion
tabelle Delta Lake e processamento dati
integrazione dati ADLS Gen2
pulizia, trasformazione e aggregazione dei dati
controlli di qualità e validazione dei dati
risoluzione problemi e ottimizzazione delle pipeline
progettazione orchestrazione ADF
documentazione e guida all'implementazione
Il mio approccio
Mi concentro sulla creazione di soluzioni di dati manutenibili, scalabili e ben strutturate, piuttosto che scrivere semplicemente codice. Esamino le tue fonti di dati, regole di business, trasformazioni, output attesi e requisiti tecnici prima di progettare la soluzione.
Prima di ordinare: Contattami per workload complessi o in produzione e condividi le tue fonti di dati, output attesi, architettura target, requisiti di trasformazione e dettagli dell'ambiente Azure.

Expertise:
Automazione
•
Altro
Provider Cloud:
microsoft azure
Traduzione automatica.
FAQ 1 — Con quali tipi di progetti Azure Databricks puoi aiutarmi?
Posso aiutarti con pipeline ETL/ELT, trasformazioni PySpark e Spark SQL, processamento Delta Lake, architettura Medallion Bronze-Silver-Gold, qualità dei dati, validazione, risoluzione problemi e ottimizzazione delle performance.
FAQ 2 — Puoi costruire pipeline Bronze, Silver e Gold Medallion?
Sì. Posso progettare e costruire pipeline Medallion dove Bronze contiene i dati grezzi, Silver applica pulizia e trasformazioni, e Gold prepara dataset pronti per analisi e report.
FAQ 3 — Con quali tecnologie puoi lavorare per questo servizio?
A seconda del progetto, posso lavorare con Azure Databricks, PySpark, Spark SQL, Delta Lake, ADLS Gen2, Azure Data Factory, SQL e Python.
FAQ 4 — Puoi integrare Azure Data Factory con Databricks?
Sì. Posso supportare progetti di orchestrazione ADF per l'ingestione dei dati, il trigger del processamento in Databricks, la gestione delle dipendenze e workflow end-to-end ETL/ELT.
FAQ 5 — Puoi ottimizzare una pipeline PySpark o Databricks esistente?
Sì. Posso revisionare trasformazioni, join, partizionamenti, caching, comportamento dello shuffle, design delle Delta-table e altri aspetti rilevanti per migliorare le performance.
FAQ 6 — Hai bisogno di accesso al mio ambiente Azure o Databricks?
Non sempre. Per alcuni progetti, codice, dati rappresentativi, dettagli dell'architettura, requisiti e output attesi possono essere sufficienti. L'accesso all'ambiente può essere discusso quando è necessario per implementazione o testing.
FAQ 7 — Puoi lavorare su grandi progetti Databricks o in produzione?
Sì, ma ti prego di contattarmi prima di ordinare. Progetti con più fonti di dati, trasformazioni complesse, deployment in produzione, requisiti di sicurezza, orchestrazione o grandi workload potrebbero richiedere un scope personalizzato e un'offerta dedicata.