Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere informatico AI
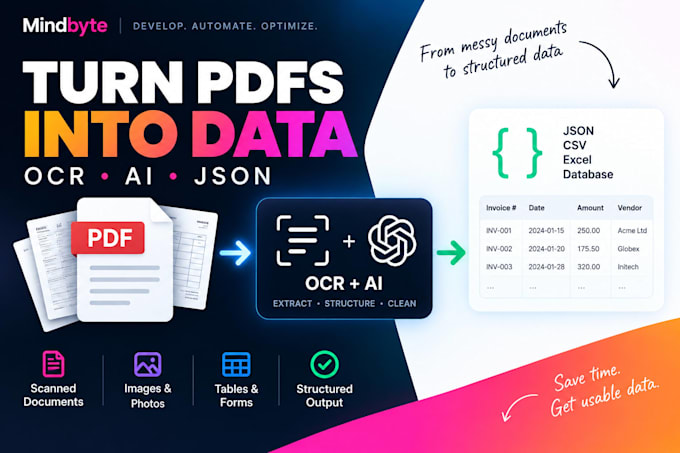
Creo pipeline di OCR e di elaborazione documenti che trasformano PDF, scansioni e immagini in dati strutturati e utilizzabili.
Posso estrarre testo, tabelle, date, riferimenti, ID e campi personalizzati, classificare i documenti, pulire i risultati e restituire output strutturato in JSON, CSV o pronto per il database.
A seconda del progetto, posso anche sviluppare API, elaborazioni asincrone, ricerche semantiche o workflow RAG.
Il mio obiettivo è un'elaborazione documenti affidabile e riutilizzabile, piuttosto che una semplice conversione PDF one-off.
Per favore, invia campioni rappresentativi di documenti prima di ordinare progetti complessi.
Tecnologia:
Python
Traduzione automatica.
Puoi processare PDF scansionati?
Sì. Posso elaborare PDF scannerizzati e immagini, incluso preprocessing quando necessario.
Puoi estrarre campi specifici?
Sì. Data, ID, riferimenti, titoli, tipi di documento e altri campi possono essere estratti.
Puoi classificare i documenti?
Sì. La classificazione può usare regole, machine learning o AI a seconda del caso d'uso.
Puoi estrarre tabelle?
Sì, a seconda del layout del documento e della qualità dello scan.
Puoi costruire un'API intorno alla pipeline?
Sì. È possibile aggiungere API REST e elaborazione in background.
Puoi processare grandi volumi?
Sì, ma workflow ad alto volume di solito richiedono un scope personalizzato.
