Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD

Traduzione automatica.
Vuoi convertire un grande volume di documenti scansionati e file non testuali in testo adatto per Rag? Posso farlo per te. Ma non solo.
Un buon RAG inizia con un repository di ricerca o documenti di progetto prima che i documenti vengano archiviati. I documenti di testo contengono sempre molte informazioni che interferiscono con la ricerca lessicale o vettoriale: liste, immagini, riferimenti, note a piè di pagina, ecc. Non solo occupano spazio nel tuo database, ma sprecano anche risorse nel processo di ricerca e producono molti risultati ridondanti. Rimuovere manualmente questo rumore è molto difficile e richiede tempo. Automatizzare questo processo richiede uno strumento che riconosca il rumore dal contenuto e non elimini per errore il contenuto dei tuoi testi.
Ho creato MD for AI, il mio motore di elaborazione documenti che è stato testato su centinaia di libri reali. Questo motore preserva l'attribuzione in ogni frammento in modo che le parti recuperate possano rimanere collegate alla loro fonte. Ho anche una pipeline OCR separata per contenuti scansionati in persiano e multilingue.
Converto PDF, Word e altri documenti in Markdown pulito, strutturato e pronto per le citazioni, adatto per sistemi RAG, ricerca AI, GPT personalizzati e basi di conoscenza.
Programming and Tech
Lingue
Traduzione automatica.
Traduzione automatica.
È solo conversione da PDF a testo?
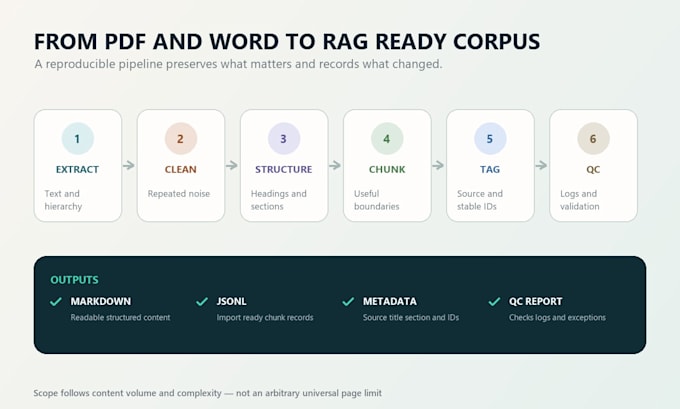
No. L'obiettivo è una struttura pronta per il retrieval: pulizia, gerarchia, frammenti, metadati, attribuzione e controlli di qualità. La semplice conversione di formato è un servizio di basso valore diverso.
Supporti PDF scansionati e immagini?
Sì, tramite OCR opzionale quotato dopo l'ispezione. L'OCR non è necessario per documenti che già contengono testo utilizzabile e non è incluso automaticamente.
Limiti ogni ordine per pagina o numero di file?
Nessun limite universale che si adatti a ogni corpus. File simili puliti possono essere processati efficientemente, mentre una scansione difficile può richiedere più lavoro. Standard e Premium sono definiti dopo un campione rappresentativo.
Quali formati di output puoi fornire?
Markdown e JSONL sono i principali output. Testo semplice, JSON strutturato o uno schema specifico del progetto possono essere discussi prima dell'ordine.
L'output funzionerà con il mio framework RAG?
Posso adattare i campi di frammento e metadati a un target concordato come una pipeline Python personalizzata, servizio FastAPI, importatore di database vettoriali o workflow RAG comparabile.