Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Trasformare i dati in soluzioni con precisione

Destination Platform:
PostgreSQL
•
MySQL
•
Apache Hive
•
Amazon S3
•
Altro
Traduzione automatica.
Come si differenzia l'ETL agentico dall'ETL tradizionale?
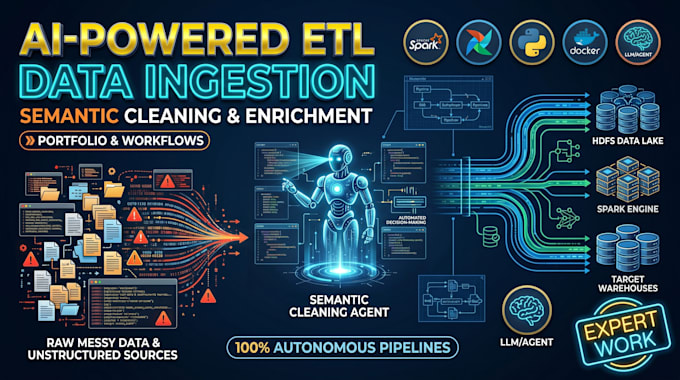
L'ETL tradizionale si basa su regole rigide e hardcoded che si rompono quando cambiano i formati dei dati. Le mie pipeline ETL agentiche usano l'AI per comprendere semanticamente, analizzare e pulire dati non strutturati o disordinati prima di inserirli in modo sicuro nel data lake HDFS, rendendo la pipeline altamente resiliente.
I miei dati aziendali sono sicuri quando uso questi agenti AI?
Anche se possiamo integrare API commerciali, sono specializzato nel deploy di LLMs sicuri e locali (come Qwen, DeepSeek, agent basati su framework) direttamente nel tuo ambiente containerizzato. Così facendo, i tuoi dati sensibili non lasciano mai la tua rete o cluster interno.
Devo migrare dalla mia infrastruttura attuale?
No. Progetto questi workflow agentici per integrarsi perfettamente con le tue configurazioni di Apache Airflow e Spark esistenti. Packaggo tutto usando Docker (o Docker Swarm per alta disponibilità) in modo che si colleghi direttamente alla tua architettura attuale.
Cosa succede se l'agente non riesce a risolvere un guasto?
Viene segnalato. Ricevi un avviso su Slack o via email con la causa principale, le righe di log rilevanti e una soluzione suggerita. Le modifiche rischiose (codice, schema, qualsiasi cosa che tocchi i dati di produzione) richiedono sempre il tuo consenso. L'agente si occupa automaticamente solo dei tipi di guasti che abbiamo concordato essere sicuri.
Puoi costruire una nuova pipeline ETL da zero, non solo ripararne una?
Sì. Progetto e costruisco pipeline di dati end-to-end: ingestione da API, database o file, trasformazione in PySpark o Python, orchestrazione in Apache Airflow e caricamento su PostgreSQL, S3, Hive o nel tuo data warehouse.