Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere di automazione e intelligenza artificiale
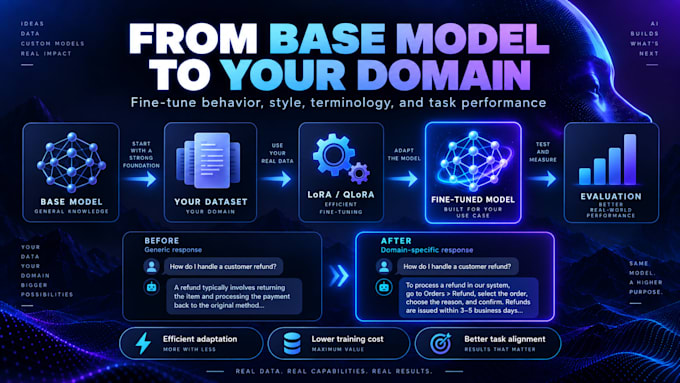
Hai bisogno di un LLM che comprenda meglio il tuo dominio, la terminologia, lo stile di scrittura, il compito o il dataset proprietario rispetto al modello di base?
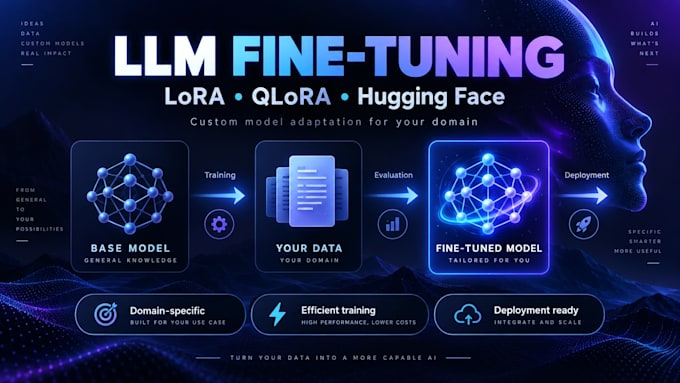
Effettuerò il fine-tuning di un Large Language Model open-source utilizzando tecniche moderne di efficienza dei parametri come LoRA e QLoRA, sfruttando l'ecosistema Hugging Face.
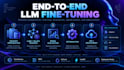
Invece di limitarmi a eseguire uno script di training, mi concentro sull'intero workflow di fine-tuning:
Dataset -> Training -> Valutazione -> Inferenza -> Deployment
Posso aiutarti con:
Posso lavorare con modelli open-source adatti dell'ecosistema Hugging Face, tra cui la famiglia Llama, Qwen, Mistral, Gemma e modelli di linguaggio basati su transformer simili.

Fortinet
Cybersecurity
I worked with Sken.ai, now acquired by Fortinet, on a short-term project, conducting machine learning experiments on proprietary data. Using AWS, I focused on finding patterns, clustering, and classification within textual data.
apr 2021-apr 2021
Traduzione automatica.
Cos'è LoRA?
LoRA è una tecnica di fine-tuning efficiente in termini di parametri che adatta un grande modello linguistico addestrando un numero relativamente piccolo di parametri aggiuntivi invece di aggiornare l'intero modello. Questo riduce significativamente l'uso di memoria GPU e i requisiti di training.
Cos'è QLoRA?
QLoRA combina la quantizzazione con LoRA in modo che i grandi modelli possano essere fine-tuned usando molto meno memoria GPU, mantenendo gran parte delle loro capacità originali. È particolarmente utile quando le risorse di calcolo sono limitate.
Puoi fare fine-tuning di qualsiasi modello Hugging Face?
Posso lavorare con molti modelli basati su transformer che supportano un fine-tuning pratico attraverso l'ecosistema Hugging Face. Per favore inviami il modello esatto o le tue esigenze prima di ordinare, perché hardware, architettura, licenze e dimensione del dataset possono influenzare la fattibilità.
Puoi fare fine-tuning di modelli come Llama, Qwen, Mistral o Gemma?
Sì, dove il modello scelto, l'hardware, le licenze e i requisiti del progetto lo permettono. Consulterò la dimensione del modello e la strategia di fine-tuning in base al tuo compito e alle risorse di calcolo disponibili.
Ho bisogno di un set di dati?
Sì. Il fine-tuning richiede dati di addestramento adeguati. Se il tuo dataset necessita di una leggera ristrutturazione o formattazione, questo può essere incluso a seconda del pacchetto.
Quanti dati servono?
Dipende dal compito e dalla qualità degli esempi. Un dataset piccolo e di alta qualità può a volte superare un dataset molto più grande e rumoroso. Valuterò il dataset prima dell'addestramento e consiglierò se è adatto.
Puoi garantire che il modello fine-tuned sarà migliore?
Nessun ingegnere AI responsabile dovrebbe garantire ciò prima di aver fatto dei test. Le prestazioni dipendono dal modello di base, dalla qualità del dataset, dalla dimensione del dataset, dalla configurazione dell'addestramento, dal metodo di valutazione e dal compito target. Per questo motivo, la valutazione è inclusa nel mio workflow.
Devo usare RAG o il fine-tuning?
Risolvono problemi diversi. RAG è di solito appropriato quando il modello ha bisogno di accedere a conoscenze in continua evoluzione o private. Il fine-tuning è utile quando vuoi modificare il comportamento del modello, l'adattamento al dominio, lo stile, la terminologia, il formato di output o le prestazioni del compito. Alcuni sistemi beneficiano di entrambi.
Puoi distribuire il modello fine-tuned?
Sì. Il pacchetto Premium può includere un'API di inferenza, configurazione Docker, documentazione di distribuzione e guida all'integrazione. I costi di infrastruttura cloud e hosting GPU sono separati.
Chi paga per il training su GPU/cloud?
Qualsiasi costo significativo di terze parti per GPU, API, storage o hosting è a carico del cliente, salvo diversa indicazione nel'offerta personalizzata. Discuterò i requisiti di calcolo previsti prima dell'addestramento.
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj

Stati Uniti
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 USD-200 USD
$
4 giorni
Tempo
kr1s_ra

Austria
Pleasure doing business. Very fast delivery.
50 USD
$
3 giorni
Tempo
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj
Stati Uniti
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 USD-200 USD
$
4 giorni
Tempo
kr1s_ra
Austria
Pleasure doing business. Very fast delivery.
50 USD
$
3 giorni
Tempo