Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
AI Engineer: agent LLM, RAG, Document AI : computer vision e video analytics
Livello 1
Ha soddisfatto determinati criteri di prestazione e mostra un forte potenziale nel marketplace.
Ancora paghi qualcuno per digitare manualmente i dati da fatture, ricevute, documenti d'identità o moduli?
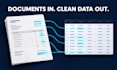
Costruisco sistemi OCR e Document AI che leggono i tuoi documenti e restituiscono dati puliti e strutturati direttamente nel tuo foglio di calcolo, database o app.
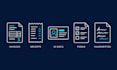
COSA ESTRAGGO
- Fatture e ricevute: voci di linea, totali, date, tasse, dettagli del fornitore
- Documenti d'identità e KYC: passaporti, patenti, carte d'identità
- Contratti e moduli: clausole, campi, firme, caselle di controllo
- Documenti scritti a mano e scansioni, anche di bassa qualità
- Tabelle, anche quando si estendono su più pagine
Ogni pipeline include regole di validazione che rilevano errori prima che arrivino a te, output in JSON, CSV o Excel strutturato, e un rapporto di accuratezza per mostrarti come funziona sui tuoi documenti, non su una demo.
STACK: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, GPT-4 Vision.
NON SEI SICURO CHE FUNZIONERÀ SUI TUOI DOCUMENTI?
Inizia con il Proof of Concept. Invia 3-5 documenti reali e ti mostrerò l'estrazione sui TUOI dati, con un rapporto di accuratezza, prima di impegnarti in una soluzione completa.
Scrivimi con 2-3 esempi e i campi di cui hai bisogno, e ti dirò onestamente cosa è possibile.

Tecnologia:
Excel
•
Fogli Google
•
Python
•
Zapier
•
Altro
Traduzione automatica.
Questo funzionerà sui miei documenti specifici?
Esattamente, questo è lo scopo del package Proof of Concept. Invia 3-5 dei tuoi documenti reali e li elaborerò mostrando i risultati con un rapporto di accuratezza prima che tu decida di passare a qualcosa di più grande. Se i tuoi documenti risultano inadatti, scoprirai il motivo a un costo contenuto.
Quale precisione posso aspettarmi?
Dipende dai tuoi documenti, e chi ti dà un prezzo senza averli visti sta solo indovinando. PDF digitali puliti con layout coerenti raggiungono generalmente un'alta precisione. Scansioni di bassa qualità, scrittura a mano e layout molto variabili sono più difficili. Per questo ogni package include un rapporto di accuratezza che misura il risultato.
Ottengo il codice sorgente e un'API funzionante?
Sì, a partire dal package Standard. Ricevi il codice sorgente completo, e il Premium include un'API più deployment sul tuo server, containerizzato con Docker, e documentazione per permettere al tuo team di mantenerlo senza di me.
I miei documenti sono riservati. I miei dati sono sicuri?
Sì, e ti spiegherò nel dettaglio. Ho bisogno solo di alcuni esempi, e puoi oscurare i valori sensibili prima di inviarli. Se i tuoi documenti non possono essere processati da servizi di terze parti, posso costruire l'intera pipeline usando OCR open-source auto-ospitato, così niente lascia la tua infrastruttura. Te
Puoi gestire testo scritto a mano o scansioni di bassa qualità?
Spesso sì, ma onestamente varia più di quanto faccia il testo stampato. Scrittura a mano, scansioni sbiadite, foto distorte e fax a bassa risoluzione riducono l'accuratezza, e la misura dipende dai tuoi documenti specifici. Il pre-processing aiuta molto. Invia esempi dei tuoi documenti peggiori nel Proof of Concept e io
Quale formato di output ottengo?
Qualunque si adatti al tuo flusso di lavoro: JSON strutturato, CSV, Excel, o scritto direttamente nel tuo database o app tramite API. Dimmi dove devono finire i dati e te li consegnerò in quel formato, invece di darti un file da convertire tu stesso.


