Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Senior DevOps e MLOps engineer, CICD, Kubernetes, AWS, sviluppatore full stack
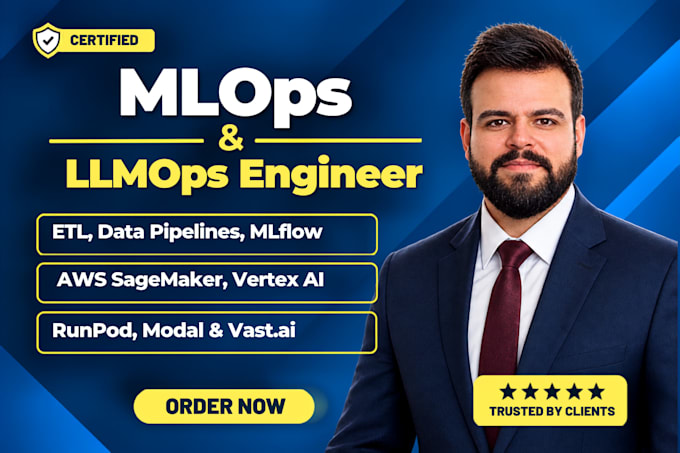
Hai difficoltà a distribuire i tuoi modelli AI/ML o LLM in produzione? Sono un Senior MLOps e LLMOps Engineer specializzato nello sviluppo e distribuzione di modelli ML, ottimizzazione, pipeline end-to-end, tracciamento con MLflow, sistemi RAG con LangChain e distribuzione scalabile di LLM su GPU.
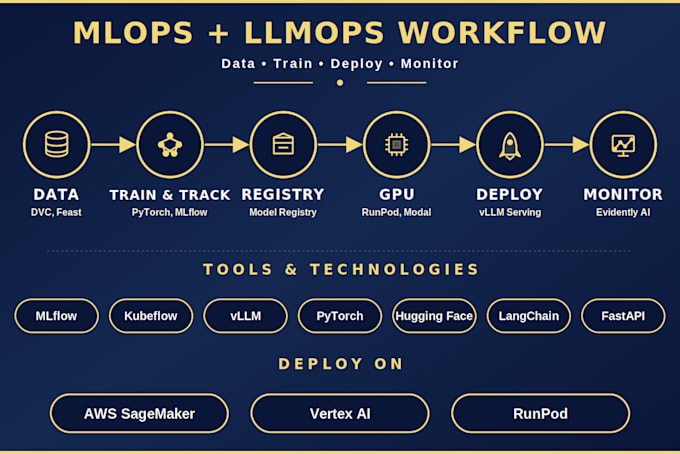
Costruisco pipeline MLOps di livello produzione per automatizzare sviluppo, training, ottimizzazione, testing, distribuzione, monitoraggio e retraining continuo, in modo rapido, sicuro e scalabile.
Servizi che offro:
Distribuisco machine learning, sistemi GenAI, RAG, LLMs ottimizzati e applicazioni AI personalizzate.
Stack tecnologico:
Python, MLflow, Kubeflow, FastAPI, LangChain, SageMaker, Vertex AI, RunPod
Pronto a distribuire il tuo modello AI/ML in produzione? Connettiamoci!

Linguaggio di programmazione:
Python
•
SQL
•
MLflow
•
Amazon SageMaker
Framework:
Scikit-learn
•
DeepPy
•
Google ML Kit
•
PyTorch
•
Panda
Traduzione automatica.
Quali modelli ML e LLM puoi distribuire?
Distribuisco tutti i tipi di modelli ML e LLM, inclusi machine learning, deep learning, NLP, GenAI, sistemi RAG, GPT, Llama, Mistral e LLMs ottimizzati. Che si tratti di un modello di classificazione, transformer o LLM open-source, lo distribuirò in produzione seguendo le migliori pratiche MLOps per scalabilità.
Puoi ottimizzare LLMs e configurare pipeline RAG?
Sì, offro fine-tuning di LLM usando LoRA e QLoRA su Hugging Face per modelli come Llama, Mistral e GPT. Costruisco anche pipeline RAG pronte per la produzione con LangChain e database vettoriali come Pinecone, FAISS o Weaviate. Ideale per chatbot, Q&A su documenti e assistenti AI personalizzati.
Con quali strumenti MLOps e piattaforme cloud lavori?
Lavoro con tutti i principali strumenti MLOps come MLflow, Kubeflow, Airflow, FastAPI e BentoML. Per il deployment su cloud uso AWS SageMaker, Google Vertex AI, Azure Machine Learning e Databricks. Per distribuzioni su GPU di LLM, lavoro con RunPod, Modal e Vast.ai.
Fornisci monitoraggio modelli e retraining automatico?
Sì, configuro monitoraggio completo dei modelli, incluso tracciamento delle performance, rilevamento drift e alert automatici con MLflow. Costruisco anche pipeline di retraining automatico che riaddestrano i modelli con nuovi dati, mantenendo alta l’accuratezza in produzione.
Puoi configurare distribuzione su GPU di LLM su RunPod o Modal?
Assolutamente! Distribuisco LLM su piattaforme cloud GPU come RunPod, Modal e Vast.ai per inferenza scalabile ed economica. Uso vLLM, Ollama e Hugging Face Text Generation Inference per un servizio ad alte prestazioni con GPU ottimizzate e auto-scaling in produzione.
Quanto tempo ci vuole per costruire una pipeline MLOps?
Distribuire un modello ML di base richiede circa 3 giorni, mentre una pipeline end-to-end completa con monitoraggio e retraining circa 5 giorni. Soluzioni complete di MLOps e LLMOps con fine-tuning, RAG e multi-cloud richiedono circa 7 giorni. I tempi variano in base alla portata del progetto, discutiamone per precisione.
Quali deliverable riceverò alla fine del progetto?
Riceverai codice sorgente completo, modelli ML/LLM distribuiti con endpoint API, dashboard di tracciamento MLflow, setup di monitoraggio e documentazione tecnica completa (livello Premium). Tutto il codice è pronto per la produzione, commentato bene e conforme alle migliori pratiche MLOps, così tu o il tuo team potrete mantenerlo facilmente.
Fornisci supporto post consegna e documentazione?
Sì! Il pacchetto standard include 3 giorni di supporto post-consegna, mentre il pacchetto Premium include 7 giorni più documentazione tecnica completa che copre architettura pipeline, passaggi di distribuzione modello e linee guida di manutenzione. Sono qui per aiutarti a risolvere problemi, rispondere alle domande e assicurare che il sistema MLOps funzioni senza intoppi.
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
colton_romy

Stati Uniti
Muneeb deployed our model with a proper pipeline, monitoring and a rollback. He also found a problem in our training data that nobody on our side had spotted, which alone was worth far more than the price.
100 USD-200 USD
$
8 giorni
Tempo
Risposta del venditore
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
colton_romy
Stati Uniti
Muneeb deployed our model with a proper pipeline, monitoring and a rollback. He also found a problem in our training data that nobody on our side had spotted, which alone was worth far more than the price.
100 USD-200 USD
$
8 giorni
Tempo
Risposta del venditore