Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dei dati
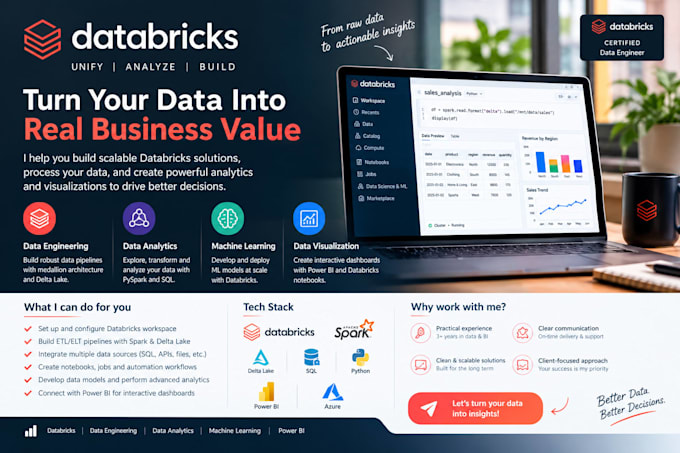
Trasforma i tuoi dati grezzi in pipeline di dati affidabili con Databricks!
Hai bisogno di aiuto con l'elaborazione dei dati, pipeline ETL o trasformazione di big data usando Databricks?
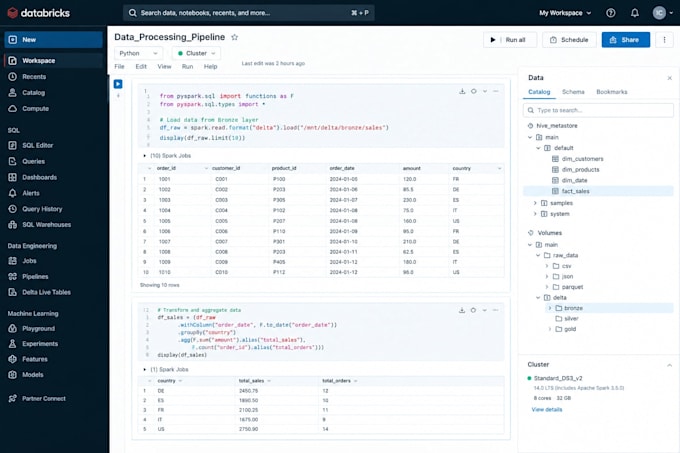
Posso aiutarti a costruire, ottimizzare e mantenere pipeline di dati usando Databricks, PySpark, Python, SQL e Delta Lake, personalizzate in base alle esigenze del tuo progetto.
Con oltre 3 anni di esperienza in analisi dei dati, sviluppo ETL, trasformazione dei dati e business intelligence, so come trasformare dati grezzi in set di dati strutturati, affidabili e pronti per l'analisi.
I miei servizi Databricks
1. Sviluppo Databricks & PySpark
2. Pipeline ETL/ELT
3. Delta Lake & Lakehouse
4. SQL & Ottimizzazione dei dati
Traduzione automatica.
Quali sono le tue fonti e formati di dati di input?
Hai già uno spazio di lavoro Databricks?
Di cosa hai bisogno per iniziare?
Fornisci i requisiti del tuo progetto, dati di esempio, output atteso e dettagli sul tuo ambiente Databricks.