Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Web scraping e dati prodotto in Excel o CSV
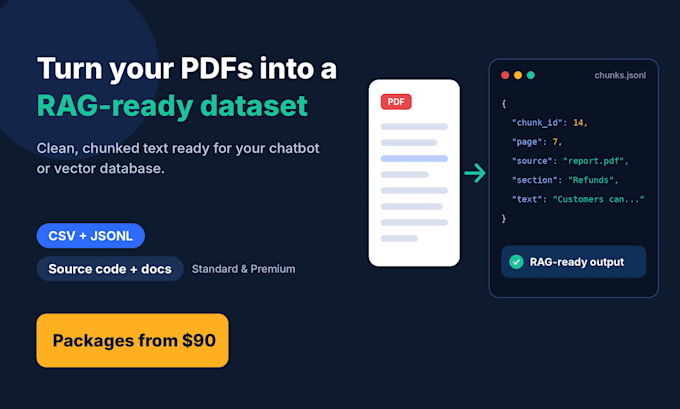
Hai bisogno che i tuoi PDF vengano convertiti in un dataset pulito pronto per RAG? Creo dati strutturati che puoi collegare direttamente al tuo pipeline RAG, chatbot o knowledge base.
Cosa ottieni:
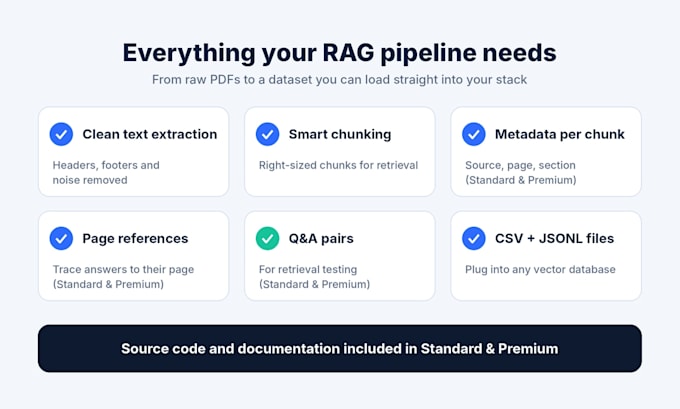
️ Estrazione testuale accurata ( intestazioni, piè di pagina e rumore eliminati)
️ Suddivisione intelligente con riferimenti alle pagine
️ Metadata per ogni pezzo ( Fonte, pagina, sezione)
️ Casi Q&A già pronti per test di recupero e valutazione LLM (Standard & Premium)
️ Dataset JSONL + CSV, pronto per il tuo pipeline RAG e per il vettore di database
️ Codice sorgente e documentazione (Standard & Premium)
Come lavoro: verifico gli output su più modelli e controllo manualmente i campioni rispetto al testo di origine per ridurre allucinazioni. Tratto i tuoi file in modo riservato.
Ideale per: startup AI, costruttori di chatbot, ricercatori e sviluppatori che costruiscono una knowledge base o un pipeline RAG.
Inizia con Basic per testare un PDF, poi scala. Scrivimi prima di ordinarlo con il tipo di PDF e il numero di pagine!

Expertise:
Altro
Framework:
Panda
Tipo di dati:
Testo
Linguaggio di programmazione:
Python
•
SQL
Strumenti:
Excel
•
Colab
API:
OpenAI
Traduzione automatica.
Quali file accettate?
Solo PDF. Se il tuo file è Word, PPT o un’immagine, scrivimi prima così posso confermare se può essere convertito.
Lavori con PDF scansionati?
I PDF basati su testo funzionano meglio. I PDF scansionati richiedono OCR e potrebbe essere necessario più tempo o un’offerta personalizzata, quindi invia una pagina di esempio prima di ordinare.
Cosa riceverò?
Ogni pacchetto ti offre un dataset CSV + JSONL pulito con testo suddiviso. Standard & Premium includono anche metadata, riferimenti alle pagine, coppie Q&A, codice sorgente e documentazione.
I miei file sono confidenziali?
Sì. Non condivido né riutilizzo i tuoi file con nessun altro. Se i tuoi documenti sono sensibili, dimmelo prima di ordinare in modo che possa confermare come verranno trattati.
Quante pagine sono incluse?
Basic: 1 PDF fino a 50 pagine. Standard: 5 PDF fino a 200 pagine. Premium: 15 PDF fino a 600 pagine. Per altro, scrivimi per un’offerta personalizzata.
posso fare una prova con un PDF prima?
Sì, è proprio per questo Basic. Prova un PDF, verifica la qualità, poi scala a Standard o Premium.