Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
Ingegnere dati AWS, ETL, PySpark, AWS Glue, Airflow
Usa tutto lo spazio di 1200 caratteri per rendere il Gig ricco di parole chiave ma ancora leggibile:
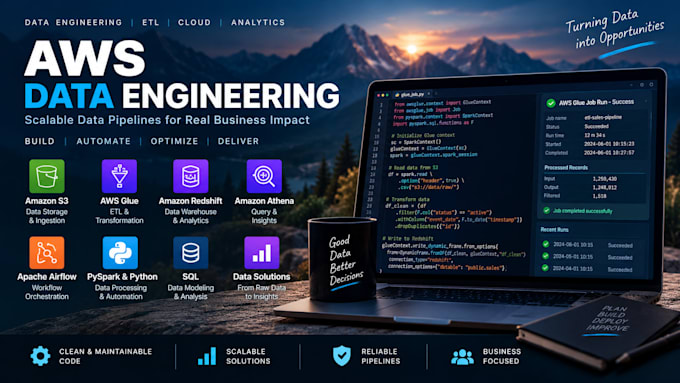
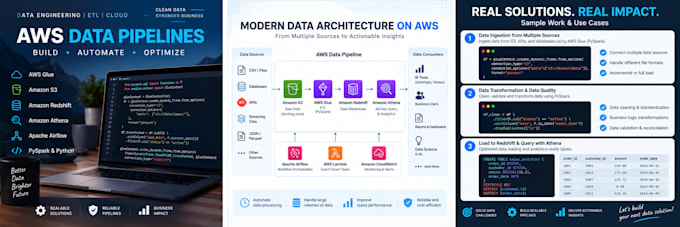
Costruirò pipeline di dati AWS ETL affidabili e scalabili usando AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift e altri servizi AWS.
Posso aiutarti a sviluppare nuove pipeline di dati, automatizzare l'elaborazione dei dati, trasformare set di dati o risolvere problemi con i workflow ETL esistenti.
I miei servizi includono:
Sviluppo di job ETL con AWS Glue
Trasformazioni di dati con PySpark e Python
Ingestione e elaborazione dati S3
Elaborazione di dati CSV, JSON e Parquet
Caricamento e trasformazione di dati Redshift
Soluzioni Athena e Apache Iceberg
Validazione e riconciliazione dei dati
Gestione degli errori e logging dei pipeline
Ottimizzazione delle performance ETL
Migrazione e automazione dei dati
Mi concentro su soluzioni pulite, manutenibili e pronte per la produzione, con validazione, gestione degli errori e documentazione adeguata.
Sia che tu abbia bisogno di un piccolo task ETL o di una pipeline di dati AWS completa, posso sviluppare una soluzione in base alle tue esigenze.
Contattami prima di effettuare un ordine per richieste complesse o multi-servizio, così posso capire il tuo scope e consigliarti il pacchetto più adatto.
Tecnologia:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow