Sfoglia categorie
Esplora
Fiverr Pro
Italiano
$
USD
SaaS scalabili e app web, Senior MERN, Rails e DevOps Engineer


Strumenti e piattaforme:
Kafka Connect
•
Altro
Traduzione automatica.
Riesci a sistemare una pipeline ETL esistente?
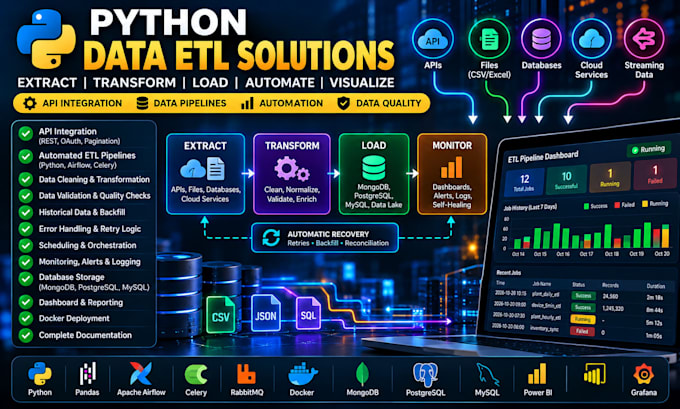
Sì. Posso rivedere gli script ETL in Python esistenti, investigare richieste API fallite, individuare errori di elaborazione dati, migliorare le operazioni sul database e implementare meccanismi di retry e recupero adeguati.
Riesci a recuperare dati storici mancanti?
Sì, purché la sorgente API o il database renda disponibili i record storici. Posso implementare workflow automatizzati di backfill che identificano periodi mancanti, recuperano i record disponibili e aggiornano in sicurezza il tuo database.
Fornisci retry automatici e recupero degli errori?
Sì. A seconda dei tuoi requisiti, posso implementare logica di retry, backoff esponenziale, tracciamento persistente dei job, code di recupero e esecuzione dei task con Celery e RabbitMQ.
Quali database supportate?
Posso lavorare con database come PostgreSQL, MongoDB e MySQL. Le integrazioni con i data warehouse cloud, tra cui BigQuery e Snowflake, possono essere discusse in base ai requisiti del progetto.
Posso monitorare le mie pipeline di dati?
Sì. Posso implementare log di esecuzione, tracciamento dello stato dei job, avvisi di errore, report di salute giornalieri e interfacce di monitoraggio personalizzate usando tecnologie backend Python.
Puoi garantire che non perderai mai dati?
Nessun sistema può garantire la disponibilità dei dati forniti da fornitori esterni. Tuttavia, posso implementare tracciamento di esecuzione affidabile, validazione, retry, riconciliazione e meccanismi di recupero per ridurre le perdite di dati evitabili e rilevare lacune non risolte.