Sfoglia categorie
Italiano
$
USD
Connettiti alla tua IA
Tecnologia:
Python
Expertise:
Estrazione dati
•
Manipolazione dati
Traduzione automatica.
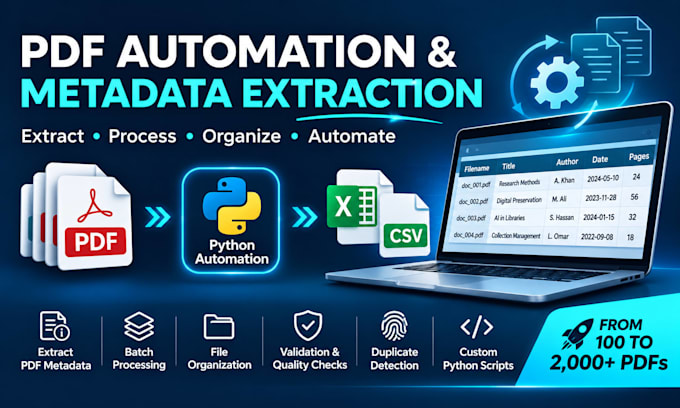
Puoi processare centinaia o migliaia di file PDF?
Sì! Posso sviluppare workflow di automazione Python per processare grandi collezioni di PDF. I pacchetti coprono fino a 100, 500 o 2000 file, a seconda del pacchetto scelto. Collezioni più grandi potrebbero richiedere un preventivo personalizzato.
Quali informazioni puoi estrarre dai file PDF?
Posso estrarre metadata disponibili come titoli dei documenti, autori, date di creazione e modifica, conteggio delle pagine, dimensioni dei file e versioni PDF. L'estrazione dipende dalle informazioni incorporate in ogni documento.
Puoi estrarre testo da PDF scannerizzati?
Sì, l'estrazione basata su OCR può essere discussa come servizio su misura. I pacchetti standard si concentrano sui metadata incorporati nei PDF e non includono OCR o riconoscimento del testo scritto a mano.
In quale formato riceverò i dati estratti?
CSV è incluso in tutti i pacchetti. È possibile fornire anche output Excel (.xlsx) o JSON previo accordo prima dell'ordine. Script Python riutilizzabili sono inclusi nei pacchetti Standard e Premium.
Hai bisogno di accesso al mio computer o server?
Di solito non serve accesso remoto. Posso sviluppare e testare la soluzione usando file di esempio rappresentativi. Poi potrai eseguire lo script fornito sul tuo computer Windows o Linux.
Come gestisci i documenti riservati?
Consiglio di condividere campioni anonimizzati o non sensibili quando possibile. Utilizzo i file di progetto solo per il lavoro concordato e non li condivido con terze parti. Discuti eventuali requisiti di riservatezza o gestione dei dati prima di ordinare.
Puoi creare un workflow di elaborazione PDF personalizzato?
Sì! Posso sviluppare workflow per estrazione di metadata, rinominazione in batch, rilevamento duplicati, validazione dei file e report strutturato. Contattami con i tuoi requisiti per valutare l'ambito e fornire un preventivo adeguato.
